- UC Berkeley CS 182 (Spring 2021) 9강 정리
- 강의: Sergey Levine
합성곱 신경망은 무엇을 보는가
왜 시각화하는가
뇌가 무엇을 보는지 묻듯이, 합성곱 신경망이 무엇을 “보는지” 물을 수 있다. 이것이 궁금한 이유는 여러 가지다.
- 신경망이 무엇에 주의를 기울이는지 해석한다.
- 언제 잘 작동하고 언제 실패할지 이해한다.
- 서로 다른 모델과 구조를 비교한다.
- 합성곱 신경망의 반응을 바탕으로 이미지를 조작한다.
무엇을 시각화하는가
두 가지 선택지가 있다.
- 선택 1: 필터 자체를 시각화한다. 이 필터는 어떤 이미지 특징에 대응하는가?
- 선택 2: “뉴런”을 활성화하는 자극을 시각화한다. 어떤 이미지 조각이 이 필터의 출력을 크게 만드는가?
필터 시각화
첫 층 필터는 입력과 같은 RGB 공간에 있으므로 작은 이미지로 그대로 그려 볼 수 있다. 그러면 다양한 방향의 경계, 색 대비 같은 패턴이 보인다. 하지만 더 높은 층의 필터는 이전 층의 특징 채널들에 대한 가중치이므로, 그대로 그려서는 의미 있게 해석하기 어렵다.
뉴런 반응 시각화
아이디어 1은 특정 유닛을 최대로 “흥분”시키는 이미지를 찾는 것이다. 많은 이미지(또는 조각)를 신경망에 넣고, 관심 있는 유닛의 활성화 값(예: 12.3, 37.4, 17.1, 21.4, 42.1)을 기록한 뒤, 값이 가장 큰 이미지 조각들을 모아 본다. Girshick et al.(2014)은 이 방식으로 높은 층의 유닛들이 얼굴, 개, 글자, 반사광 같은 의미 있는 패턴에 반응함을 보였다.
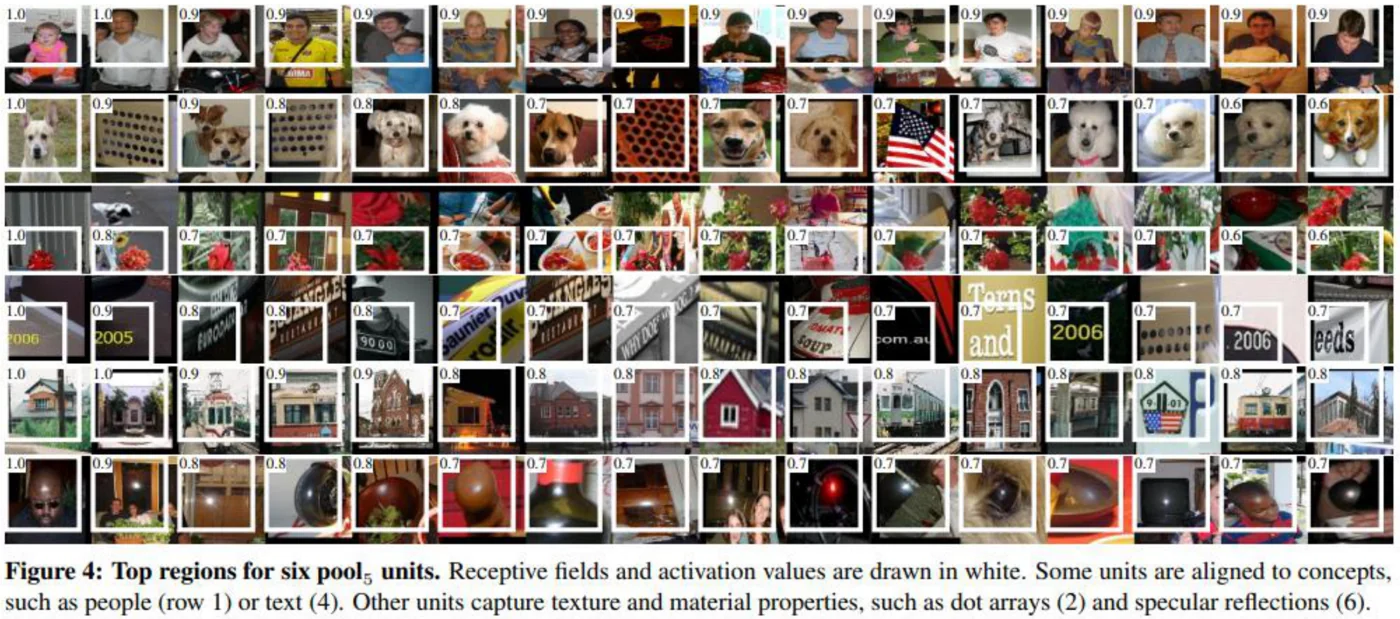 pool5 층의 유닛 여섯 개 각각에 대해 활성화가 가장 큰 이미지 영역을 한 줄씩 모은 것이다. 흰 상자가 수용 영역, 숫자가 활성화 값이다. 출처: CS 182 Lecture 9 slides.
그림의 각 줄은 하나의 유닛이고, 왼쪽으로 갈수록 활성화가 크다(1.0에서 0.6 정도로 정규화된 값). 첫 줄의 유닛은 사람에, 넷째 줄의 유닛은 글자나 숫자에 반응하므로 어떤 “개념”에 맞춰진 유닛이라 할 수 있다. 반면 둘째 줄은 개 얼굴뿐 아니라 점이 규칙적으로 박힌 판에도 반응하고, 여섯째 줄은 물체 종류와 상관없이 반짝이는 반사광에 반응한다. 즉 어떤 유닛은 의미 범주를, 어떤 유닛은 질감이나 재질 같은 낮은 수준의 성질을 잡아낸다.
이 방법의 장점은 신경망을 수정하지 않고 데이터셋을 한 번 훑기만 하면 된다는 점이다. 단점은 유닛이 이미지 조각의 어느 부분에 반응하는지까지는 알려 주지 않는다는 점이며, 이를 보려면 다음의 기울기 기반 방법이 필요하다.
기울기를 이용한 시각화
어떤 이미지 픽셀이 특정 유닛의 값에 가장 큰 영향을 미치는지 볼 수도 있다. 여기서 “영향”이란 무엇인가? 픽셀 \(x_{ij}\)와 \(\ell\)번째 층의 유닛 \(a^{\ell}_{mnp}\)가 주어졌을 때, \(x_{ij}\)를 바꾸면 \(a^{\ell}_{mnp}\)가 얼마나 바뀌는가, 즉 다음 미분이다.
\[\frac{d a^{\ell}_{mnp}}{d x_{ij}}\]이 값은 역전파로 구한다. 손실 대신 유닛 하나에서 역전파를 시작하면 된다.
- \(\delta\)를 \(a^{\ell}\)과 같은 크기로 만든다.
- \(\delta_{mnp} = 1\), 나머지 성분은 0으로 둔다. 이것이 \(d a^{\ell}_{mnp} / d a^{\ell}\)이다.
- \(\ell\)층에서 이미지까지 역전파한다. 각 층 \(f\)(입력 \(x_f\))에 대해 \(\delta \leftarrow \frac{df}{dx_f} \delta\)를 반복한다.
- 마지막 \(\delta\)가 \(d a^{\ell}_{mnp} / dx\)다.
유도 역전파
그냥 역전파한 결과는 잘 해석되지 않는다. 신경망의 많은 유닛이 양의 기울기와 음의 기울기를 모두 보내 서로 얽히기 때문이다. 유도 역전파(guided backpropagation) (Springenberg et al., 2014)는 역전파를 조금 수정한다. ReLU를 통과할 때 순전파 입력이 양수인 곳에서만 기울기를 통과시키는 일반 규칙에 더해, 기울기 자체도 양수인 것만 남긴다. 복잡한 음의 기여를 피하면 훨씬 깨끗한 신호가 나오고, 결과 이미지에서 유닛이 반응하는 물체의 윤곽이 선명하게 드러난다. 더 깊은 층(예: CONV6, CONV9)의 유닛일수록 더 크고 복잡한 패턴에 반응한다.
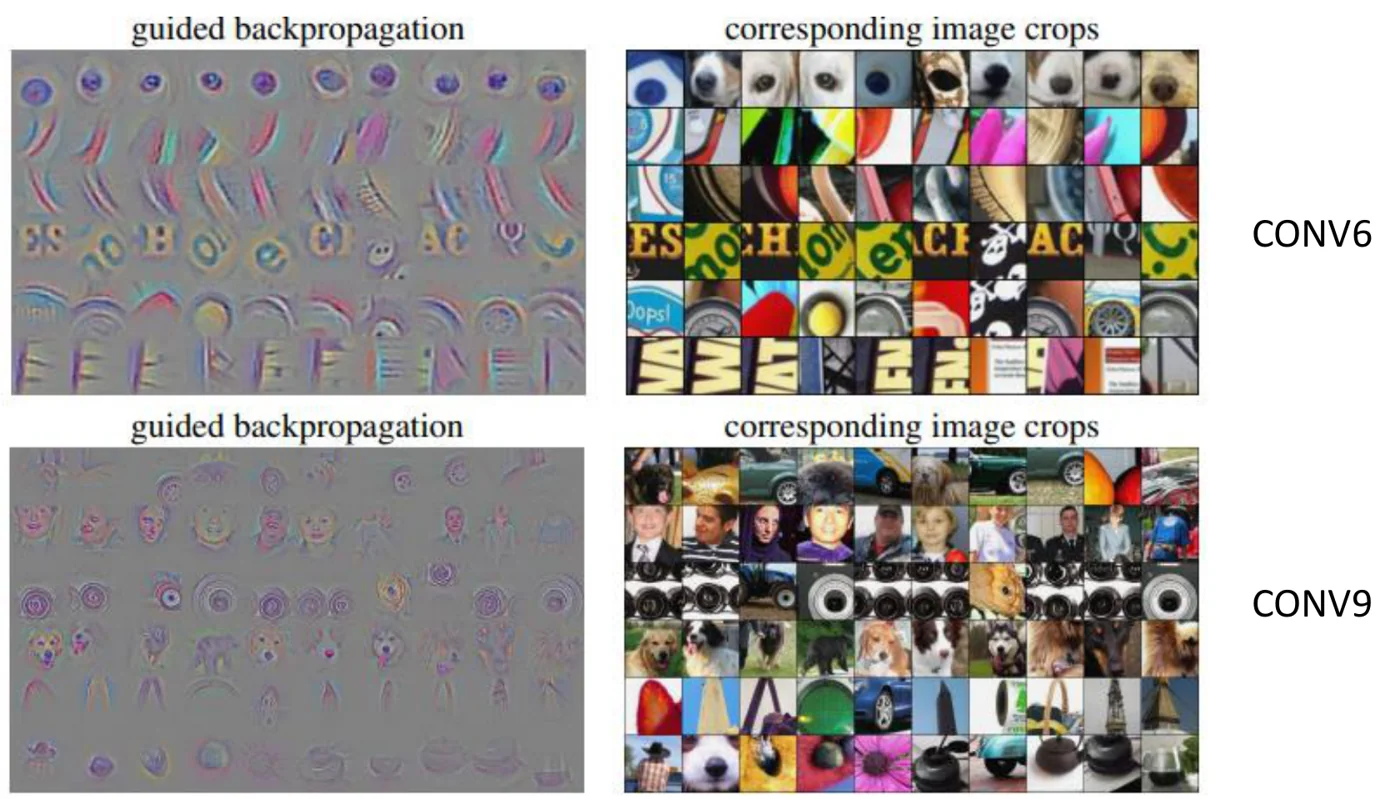 왼쪽은 유도 역전파로 얻은 픽셀 기울기, 오른쪽은 같은 유닛을 크게 활성화한 실제 이미지 조각이다. 위는 CONV6, 아래는 CONV9 층이다. 출처: CS 182 Lecture 9 slides.
그림에서 같은 줄의 왼쪽과 오른쪽을 짝지어 보면 된다. 오른쪽 이미지 조각만으로는 유닛이 개의 눈에 반응하는지 코에 반응하는지 알기 어렵지만, 왼쪽의 유도 역전파 결과에는 그 유닛에 영향을 준 픽셀만 남아 있어 둥근 눈동자, 휘어진 곡선, 글자의 획 같은 모양이 또렷이 보인다. 배경처럼 유닛과 관계없는 부분은 회색(기울기 0)으로 지워진다.
위아래를 비교하면 층에 따른 차이도 드러난다. CONV6의 유닛은 원, 곡선, 글자 조각처럼 비교적 작고 단순한 패턴에 반응하고, CONV9의 유닛은 사람 얼굴, 개 얼굴, 바퀴처럼 더 넓은 영역을 차지하는 물체 부분에 반응한다. 층이 깊어질수록 수용 영역이 커지고 특징이 추상화된다는 것을 직접 확인할 수 있다.
역전파로 특징 시각화하기
이미지를 최적화하기
아이디어 2는 특정 유닛을 최대로 활성화하도록 이미지를 “최적화” 하는 것이다.
- 이전: 기울기 \(d a^{\ell}_{mnp} / d x_{ij}\)를 계산해서 보기만 했다.
- 이제: 기울기 \(g = d a^{\ell}_{mnp} / dx\)를 계산하고 \(x \leftarrow x + \alpha g\)로 이미지를 갱신하기를 반복한다.
이것은 다음 최적화 문제를 기울기 상승법으로 푸는 것이다.
\[x \leftarrow \arg\max_x a^{\ell}_{mnp}(x)\]더 일반적으로 \(S(x)\)를 어떤 활성화나 클래스 점수라 하면 다음과 같다.
\[x \leftarrow \arg\max_x S(x)\]이미지 정규화
문제는 “미친” 이미지를 만들기가 너무 쉽다는 점이다. 예를 들어 고양이의 눈을 더 파랗게 하면 활성화가 커진다면, 파란 채널을 10억으로 설정하면 어떻게 될까? 이를 막기 위해 이미지 정규화항 \(R(x)\)를 더한다.
\[x \leftarrow \arg\max_x S(x) + R(x)\]간단한 선택은 L2 페널티다(최대화 문제이므로 음수 부호를 붙여 큰 픽셀 값을 벌한다).
\[R(x) = -\lambda \lVert x \rVert_2^2\]클래스 시각화
어떤 유닛을 최대화할까? 먼저 클래스 레이블을 최대화해 본다(Simonyan et al., 2013). 중요한 디테일이 있다. 클래스 확률이 아니라 softmax 직전의 활성화(클래스 점수, logit)를 최대화한다. 확률은 다른 클래스의 점수를 낮추는 것만으로도 올라갈 수 있기 때문이다. 결과 이미지에는 덤벨, 달마시안, 거위 같은 클래스의 특징적인 패턴이 흐릿하게 나타난다.
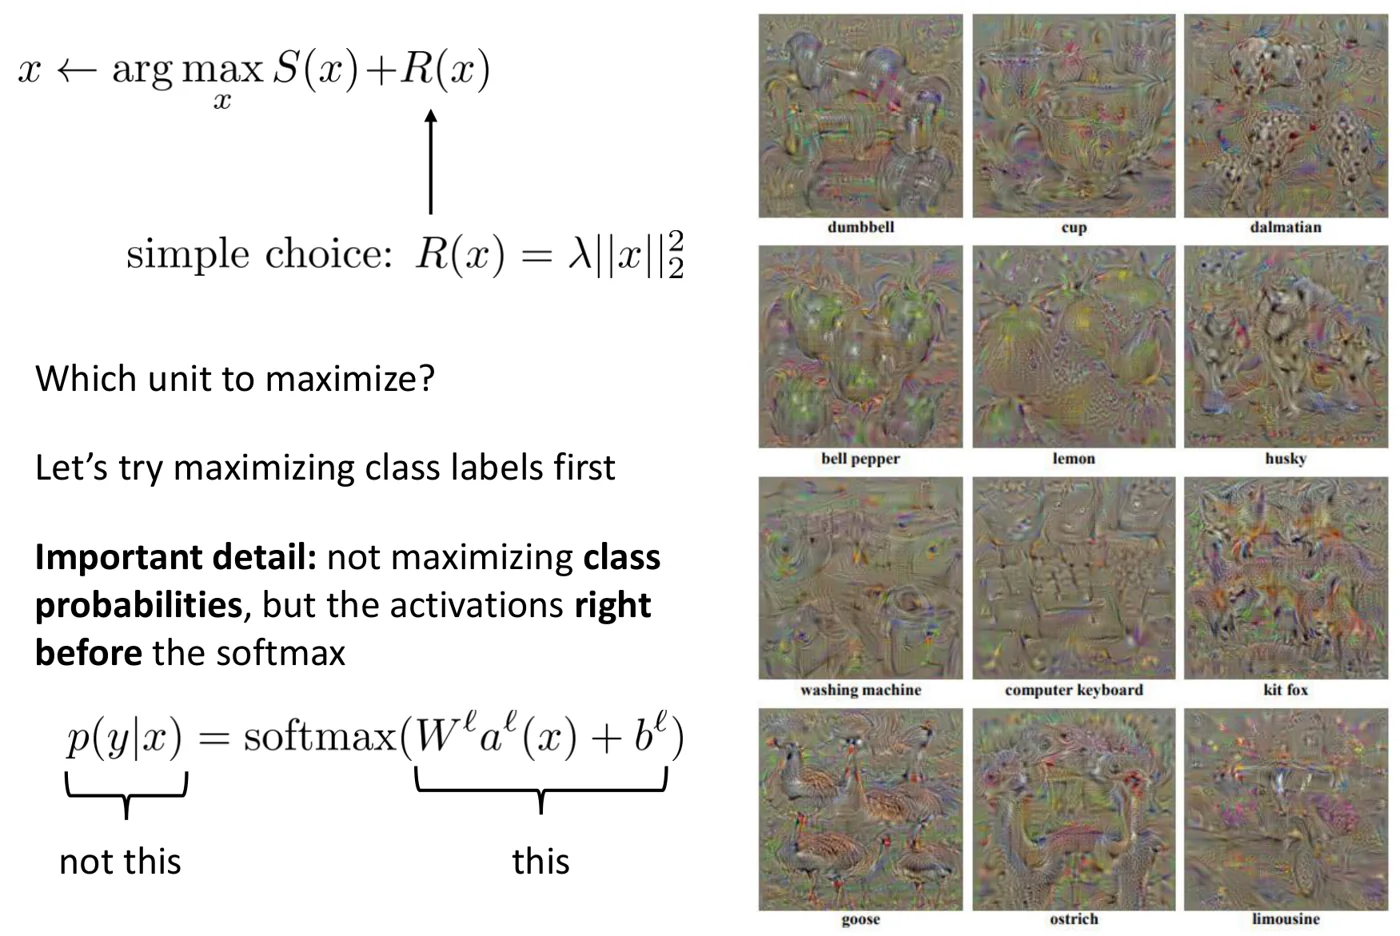 L2 정규화와 함께 클래스 점수(softmax 이전 값)를 최대화해 얻은 이미지들. 클래스마다 특징적인 모양이 여러 번 겹쳐 나타난다. 출처: CS 182 Lecture 9 slides.
그림 왼쪽 아래의 식이 “무엇을 최대화하는가”를 정리한다. \(p(y \mid x) = \mathrm{softmax}(W^{\ell} a^{\ell}(x) + b^{\ell})\)에서 왼쪽의 확률(not this)이 아니라 괄호 안의 점수(this)를 \(S(x)\)로 쓴다. 확률을 최대화하면 원하는 클래스를 키우는 대신 다른 클래스 점수를 깎는 쪽으로도 최적화가 진행되어 해석하기 어려운 이미지가 나오기 때문이다.
오른쪽 결과를 보면, 덤벨 이미지에는 덤벨의 원판과 손잡이 모양이 여러 개 흩어져 있고(흥미롭게도 덤벨을 쥔 팔의 모양도 보인다. 학습 데이터의 덤벨 사진에 팔이 자주 함께 찍혀 있기 때문이다), 달마시안 이미지에는 검은 점 무늬가, 거위와 타조 이미지에는 새의 목과 몸통이 반복된다. 물체 하나를 사실적으로 그린 그림이 아니라 “이 클래스라고 판단하게 만드는 특징들”을 이미지 곳곳에 흩뿌린 모습이다.
더 정교한 정규화
Yosinski et al.(2015)은 더 섬세한 정규화를 쓴다. 명시적인 페널티항 대신 각 단계에서 이미지를 직접 손본다.
- 기울기로 이미지를 갱신한다.
- 이미지를 약간 흐리게(blur) 한다.
- 값이 작은 픽셀은 0으로 만든다.
- 반복한다.
흐리게 하기는 고주파 잡음을 억제하고, 작은 값 제거는 관련 없는 배경을 지운다. 이렇게 하면 클래스뿐 아니라 중간 층의 개별 유닛에 대해서도 훨씬 자연스럽고 알아볼 수 있는 이미지가 나온다. 낮은 층의 유닛은 단순한 질감을, 높은 층의 유닛은 물체의 부분이나 전체를 닮은 패턴을 보여 준다.
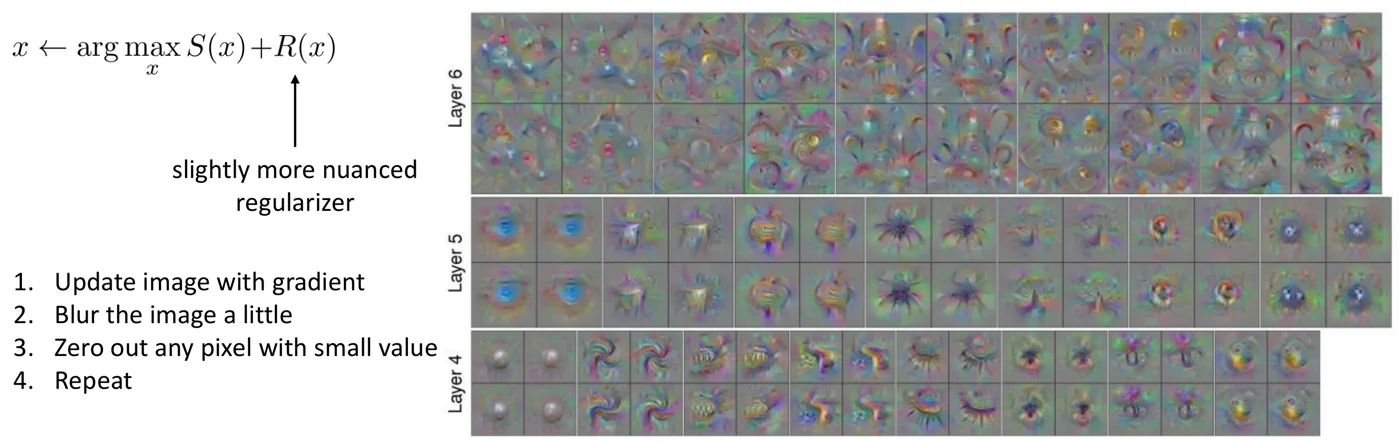 갱신, 흐리게 하기, 작은 값 제거를 반복하는 정규화로 얻은 유닛별 시각화. 아래부터 Layer 4, 5, 6이며, 서로 닮은 이웃 칸들은 같은 유닛에서 나온 결과다. 출처: CS 182 Lecture 9 slides.
그림을 아래에서 위로 읽으면 층이 깊어지는 순서다. Layer 4의 유닛은 소용돌이, 줄무늬, 작은 원처럼 단순하고 국소적인 패턴을 만든다. Layer 5에서는 눈 모양이나 방사형 구조처럼 조금 더 복잡한 패턴이 나타나고, Layer 6에서는 하나의 칸 안에 여러 부분이 배치된 더 큰 구조(얼굴이나 물체 일부를 닮은 모양)가 나타난다. 서로 닮은 칸들이 묶여 있는 것은 같은 유닛을 서로 다른 초기값이나 설정에서 최적화한 결과로, 비슷한 패턴이 나오므로 시각화가 우연이 아니라 유닛의 성질을 반영함을 보여 준다.
L2 정규화만 쓴 앞의 클래스 시각화와 비교하면 배경이 훨씬 깨끗하다. 작은 값을 0으로 만드는 단계가 유닛과 관계없는 배경 픽셀을 지우고, 흐리게 하기가 고주파 잡음을 눌러 주기 때문이다.
DeepDream과 스타일 전이
역전파로 그림을 바꿀 수 있을까
지금까지의 질문은 “conv5 층의 17번 채널은 무엇을 보고 있는가?”였다. 이제 다른 질문을 해 본다. “이 사진이 모네의 그림이라면 어떻게 보일까?” 두 질문은 어떻게 연결될까? 직관은 이렇다. 모네의 그림에는 특유의 특징 분포가 있고, 그 분포를 다른 이미지로 “옮길” 수 있다.
구름 속에서 패턴 찾기
구름을 보며 “개처럼 보인다”, “개가 어디 있는데?”, “보여 줄게!” 하는 상황을 생각하자. 신경망도 비슷하게 할 수 있다. 이미지에서 이미 약하게 감지된 특징을 더 강하게 만들면 된다. 예를 들어 눈을 더 파랗게 만들면 더 고양이 같아진다면, 그렇게 이미지를 바꾼다.
DeepDream
DeepDream의 절차는 다음과 같다.
- 층 하나를 고른다.
- 순전파로 그 층의 활성화를 계산한다.
- 역전파의 시작 기울기 \(\delta\)를 활성화 자체로 둔다.
- 이미지까지 역전파하고 기울기를 적용한다.
- 반복한다.
\(\delta = a^{\ell}\)로 두는 것은 다음 목적함수에 대한 기울기 상승과 같다.
\[\max_x \tfrac{1}{2} \lVert a^{\ell}(x) \rVert^2, \qquad \frac{d}{d a^{\ell}} \tfrac{1}{2} \lVert a^{\ell} \rVert^2 = a^{\ell}\]즉 그 층이 이미 감지한 모든 것을 증폭한다. 반복할수록 이미지 곳곳에 개 얼굴, 눈, 건물 같은 패턴이 나타나는 몽환적인 이미지가 된다. 앞에서 본 정규화 요령(흐리게 하기 등)도 함께 쓴다.
또 다른 아이디어: 스타일 전이
한 이미지의 특징을 과장하는 대신, 한 이미지의 특징을 다른 이미지의 특징처럼 보이게 하면 어떨까? 이미지를 두 측면으로 나눈다.
- 스타일(style): 특징들 사이의 관계. 예: 각과 직선이 많다.
- 내용(content): 특징들의 공간적 위치. 예: 곡선, 경계, 모서리가 어디에 있는가.
스타일을 정량화하기
스타일은 어떤 특징들이 함께 나타나는가로 볼 수 있다. “직선이 보일 때마다 이 질감도 보인다”, “곡선이 보일 때마다 평평한 음영도 보인다” 같은 관계다.
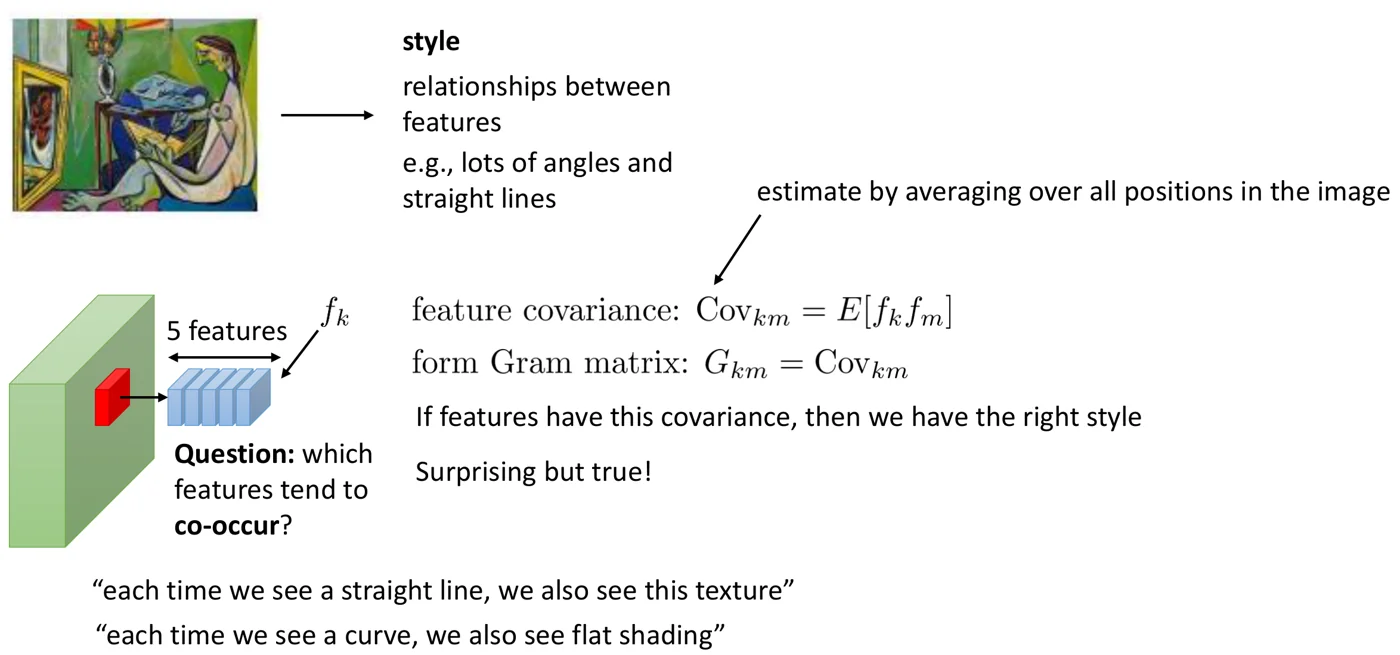 스타일은 특징들 사이의 관계다. 한 층의 각 위치에서 나온 특징 벡터(예: 5개 채널)의 공분산을 이미지 전체에서 평균해 그람 행렬을 만든다. 출처: CS 182 Lecture 9 slides.
그림의 초록 블록은 합성곱 층의 특징 맵이고, 빨간 칸은 그 안의 한 위치다. 그 위치의 채널 값들을 꺼내면 파란 특징 벡터(여기서는 5개 특징 \(f_1, \dots, f_5\))가 된다. “어떤 특징들이 함께 나타나는가?”라는 질문은 이 벡터의 두 성분 \(f_k, f_m\)이 동시에 큰 값을 갖는 경향이 있는가로 바꿀 수 있고, 이것을 모든 위치에 걸쳐 평균한 것이 공분산이다. 그림 아래의 두 문장, “직선이 보일 때마다 이 질감도 보인다”, “곡선이 보일 때마다 평평한 음영도 보인다”가 바로 그람 행렬의 한 성분이 담는 정보의 예다.
어떤 층의 한 위치에서 특징 벡터 \(f\)(예: 5개 채널 \(f_1, \dots, f_5\))를 생각하자. 특징 공분산을 이미지의 모든 위치에 대해 평균해 추정한다.
\[\mathrm{Cov}_{km} = E[f_k f_m]\]이것으로 그람 행렬(Gram matrix) \(G_{km} = \mathrm{Cov}_{km}\)을 만든다. 위치 \((i, j)\)의 특징을 \(f_{ijk}\)라 하면 다음과 같다.
\[G_{km} = \frac{1}{HW} \sum_{i,j} f_{ijk} \, f_{ijm}\]놀랍게도, 특징들이 이 공분산을 가지면 올바른 스타일을 얻는다(Gatys et al., 2015). 공간 위치에 대해 평균하므로 그람 행렬은 특징이 어디에 있는지는 버리고 무엇이 함께 나타나는지만 남긴다.
스타일 원본 이미지의 \(\ell\)층 그람 행렬을 \(G^{\ell}\), 새 이미지 \(x\)의 \(\ell\)층 그람 행렬을 \(A^{\ell}(x)\)라 하자. 스타일 손실은 다음과 같다.
\[\mathcal{L}_{\text{style}}(x) = \sum_{\ell} \sum_{k,m} \left(G^{\ell}_{km} - A^{\ell}_{km}(x)\right)^2 w_{\ell}\]층마다 가중치 \(w_{\ell}\)을 다르게 두어, 서로 다른 추상화 수준의 스타일이 원하는 만큼 기여하도록 조절한다.
내용을 정량화하기
내용은 특징의 공간적 위치이므로, 특징을 그대로 맞추면 된다. 내용 매칭에는 특정한 층 \(\ell\) 하나를 고른다.
\[\mathcal{L}_{\text{content}}(x) = \sum_{i,j} \sum_{k} \left(f^{\ell}_{ijk}(x_{\text{content}}) - f^{\ell}_{ijk}(x)\right)^2\]스타일 전이
새 이미지는 두 손실의 합을 최소화해 얻는다.
\[x \leftarrow \arg\min_x \mathcal{L}_{\text{style}}(x) + \mathcal{L}_{\text{content}}(x)\]사전학습된 합성곱 신경망의 가중치는 고정하고, 이미지 \(x\)에 대해 역전파로 기울기를 구해 최적화한다. 결과는 내용 사진의 구도를 유지하면서 스타일 그림의 붓질과 색감을 띤 이미지다. 실제로는 두 항 사이의 상대적 가중치를 조절해 내용과 스타일의 균형을 맞춘다.
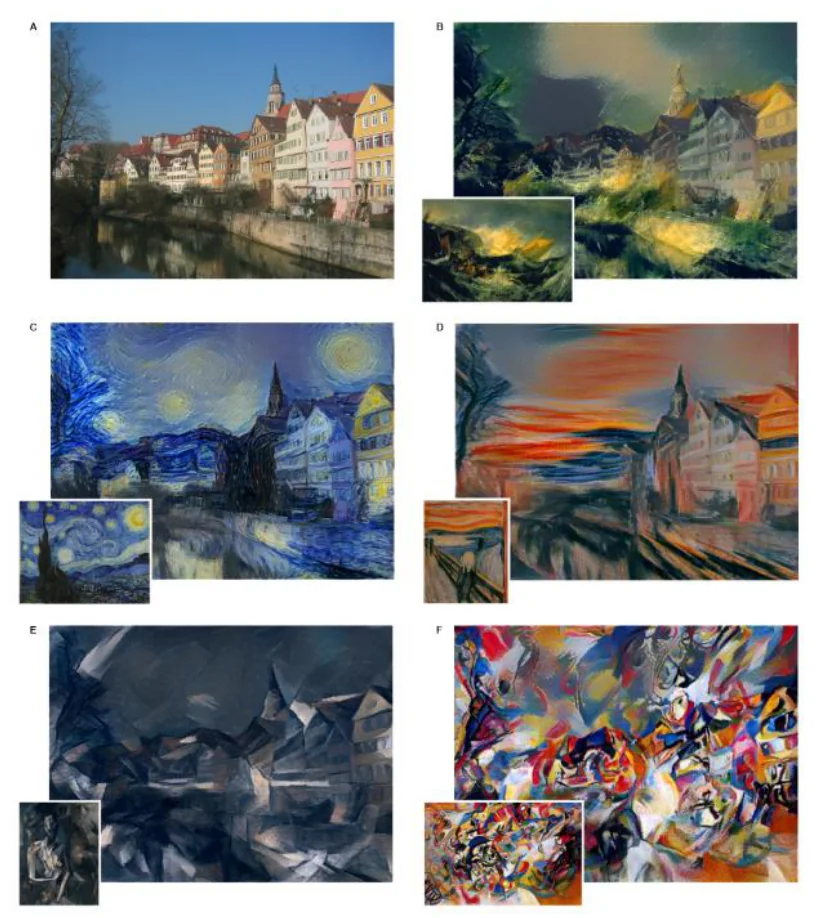 A는 내용 이미지(튀빙겐의 강변 사진)이고, B-F는 왼쪽 아래 작은 그림의 스타일을 입힌 결과다. 출처: CS 182 Lecture 9 slides.
그림의 A가 \(x_{\text{content}}\)다. B부터 F까지는 같은 사진에 서로 다른 그림의 스타일을 입힌 것으로, 각 칸 왼쪽 아래의 작은 그림이 스타일 원본이다. 예를 들어 C는 고흐의 「별이 빛나는 밤」, D는 뭉크의 「절규」를 스타일로 썼다. 어느 결과에서나 건물의 배치, 첨탑의 위치, 강과 하늘의 경계 같은 공간 구조는 A와 같다. 이것이 내용 손실이 특정 층의 특징을 위치별로 맞추기 때문에 보존되는 부분이다.
반면 색감, 붓질의 방향과 굵기, 소용돌이나 각진 면 같은 질감은 스타일 그림을 따른다. 그람 행렬은 위치 정보를 버리고 특징의 동시 출현만 맞추므로, 「별이 빛나는 밤」의 소용돌이 무늬가 원래 그림의 하늘 위치가 아니라 사진의 하늘과 건물 곳곳에 퍼져 나타난다. E와 F처럼 추상적인 그림을 스타일로 쓰면 내용이 많이 흐려지는데, 두 손실의 가중치 비율에 따라 이 균형이 달라진다.
정리
- 첫 층 필터는 직접 그려 볼 수 있지만 높은 층은 그렇지 않으므로, 유닛을 강하게 활성화하는 이미지 조각을 찾거나 기울기를 본다.
- 픽셀이 유닛에 미치는 영향 \(d a^{\ell}_{mnp} / dx\)는 해당 유닛에서 \(\delta\)를 원-핫으로 시작하는 역전파로 구하며, 유도 역전파는 양의 기울기만 남겨 더 깨끗한 시각화를 준다.
- 이미지 자체를 기울기 상승으로 최적화하면 유닛이나 클래스 점수(softmax 이전 값)를 최대화하는 이미지를 얻는다. 정규화(L2, 흐리게 하기, 작은 값 제거)가 없으면 비현실적인 이미지가 나온다.
- DeepDream은 선택한 층의 활성화를 그대로 \(\delta\)로 역전파해, 이미 감지된 특징을 증폭한다.
- 스타일은 특징의 공분산(그람 행렬), 내용은 특정 층의 특징 자체로 정량화한다.
- 스타일 전이는 \(\mathcal{L}_{\text{style}} + \mathcal{L}_{\text{content}}\)를 이미지에 대해 최소화해 한 이미지의 내용에 다른 이미지의 스타일을 입힌다.