- UC Berkeley CS 182 (Spring 2021) 15강 정리
- 강의: Sergey Levine
- 관련 Discussion: Discussion 9
강화학습 문제의 정의 (The Reinforcement Learning Problem)
앞 강의에서 본 제어 문제의 어려움은 세 가지였다. 각 결정이 미래 입력을 바꾸고, 감독이 고수준 목표로만 주어질 수 있으며, 목표는 레이블 맞히기가 아니라 과제 달성이다. 강화학습(reinforcement learning)은 이 문제들을 정면으로 다룬다.
원하는 것을 어떻게 지정하는가: 보상
모방 학습은 전문가의 행동을 레이블로 썼다. 강화학습에서는 대신 보상 함수(reward function) \(r(s_t, a_t)\)로 무엇이 좋고 나쁜지를 지정한다. 어떤 상태와 행동이 더 좋은지를 수치로 알려 주는 것이다. 슬라이드는 여기서 관측 \(o_t\) 대신 상태 \(s_t\)로 표기를 바꾸며, 관측은 나중에 다시 다룬다고 적는다.
중요한 점은 지금 당장의 보상이 아니라 시간 전체에 걸친 보상의 합을 최대화해야 한다는 것이다. 탐욕적(greedy)으로 행동하면 당장은 이득이지만 나중에 큰 손해를 볼 수 있다.
마르코프 연쇄, MDP, POMDP
마르코프 연쇄(Markov chain) 는 \(\mathcal{M} = \{\mathcal{S}, \mathcal{T}\}\)다. \(\mathcal{S}\)는 상태 공간이고, \(\mathcal{T}\)는 전이 연산자(transition operator) 로, 다음 상태의 확률 \(p(s_{t+1} \mid s_t)\)를 정한다. 전이 확률(transition probability), 동역학(dynamics)이라고도 부르며 모두 같은 뜻이다. 상태 공간이 이산적이면 \(\mu_{t,i} = p(s_t = i)\)로 두고 \(\mathcal{T}_{i,j} = p(s_{t+1} = i \mid s_t = j)\)로 쓰면 \(\vec\mu_{t+1} = \mathcal{T} \vec\mu_t\)가 되므로 “연산자”라는 이름이 붙는다.
마르코프 결정 과정(Markov decision process, MDP) 은 여기에 행동과 보상을 추가한 것이다.
\[\mathcal{M} = \{\mathcal{S}, \mathcal{A}, \mathcal{T}, r\}, \qquad \mathcal{T}: p(s_{t+1} \mid s_t, a_t), \qquad r: \mathcal{S} \times \mathcal{A} \to \mathbb{R}\]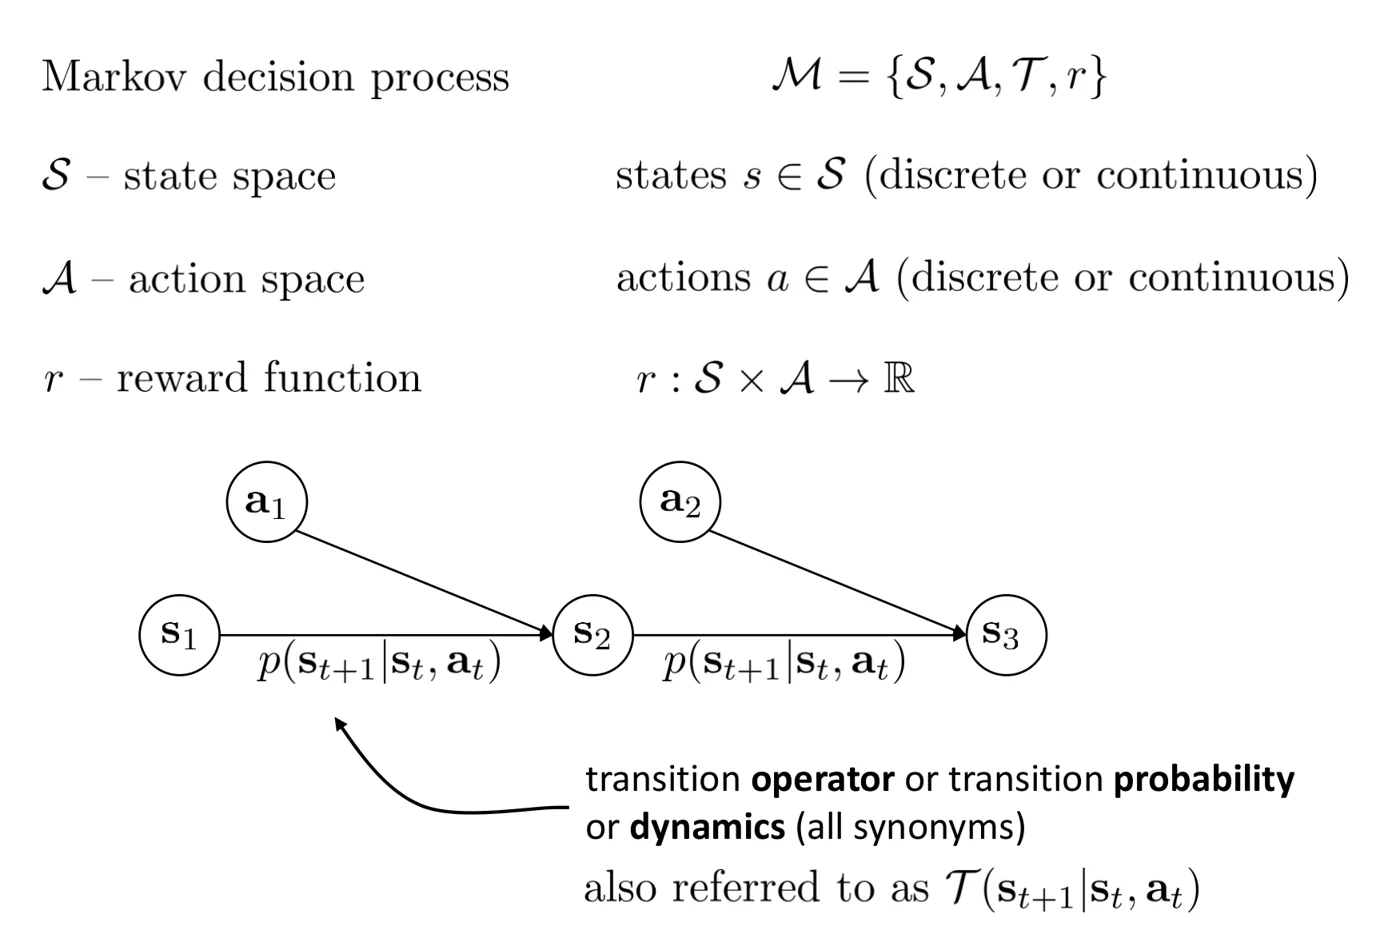 MDP의 네 구성 요소와 그래프 모형. 상태 \(s_t\)와 행동 \(a_t\)가 함께 다음 상태 \(s_{t+1}\)을 정하며, 그 화살표에 붙은 \(p(s_{t+1} \mid s_t, a_t)\)가 전이 연산자다. 출처: CS 182 Lecture 15 slides.
그림의 그래프 모형은 왼쪽에서 오른쪽으로 시간 순서대로 읽는다. 원 하나가 확률 변수 하나이고, 화살표는 “무엇이 무엇에 의존하는가”를 나타낸다. \(s_2\)로 들어오는 화살표가 \(s_1\)과 \(a_1\) 두 개뿐이므로, \(s_2\)의 분포는 바로 이전 상태와 행동만으로 정해지고 그 이전의 역사와는 무관하다. 이것이 마르코프 성질이다. 아래쪽 주석은 이 전이 확률을 전이 연산자, 전이 확률, 동역학이라고 모두 같은 의미로 부르며 \(\mathcal{T}(s_{t+1} \mid s_t, a_t)\)로도 쓴다는 점을 강조한다.
부분 관측 MDP(partially observed MDP, POMDP) 는 관측 공간 \(\mathcal{O}\)와 방출 확률(emission probability) \(\mathcal{E}: p(o_t \mid s_t)\)를 추가한 \(\mathcal{M} = \{\mathcal{S}, \mathcal{A}, \mathcal{O}, \mathcal{T}, \mathcal{E}, r\}\)이다. 에이전트는 상태를 직접 보지 못하고 관측만 본다. 슬라이드는 당분간 완전 관측 MDP만 다루되, POMDP가 존재한다는 것은 알아 두라고 한다.
강화학습의 목표
정책 \(\pi_\theta(a_t \mid s_t)\)와 환경의 동역학이 함께 궤적(trajectory) \(\tau = (s_1, a_1, \dots, s_T, a_T)\)에 대한 분포를 정한다. 마르코프 성질을 쓰면 다음과 같이 분해된다.
\[p_\theta(\tau) = p_\theta(s_1, a_1, \dots, s_T, a_T) = p(s_1) \prod_{t=1}^{T} \pi_\theta(a_t \mid s_t)\, p(s_{t+1} \mid s_t, a_t)\]강화학습의 목표는 이 분포 아래 기대 총보상을 최대화하는 정책 파라미터를 찾는 것이다.
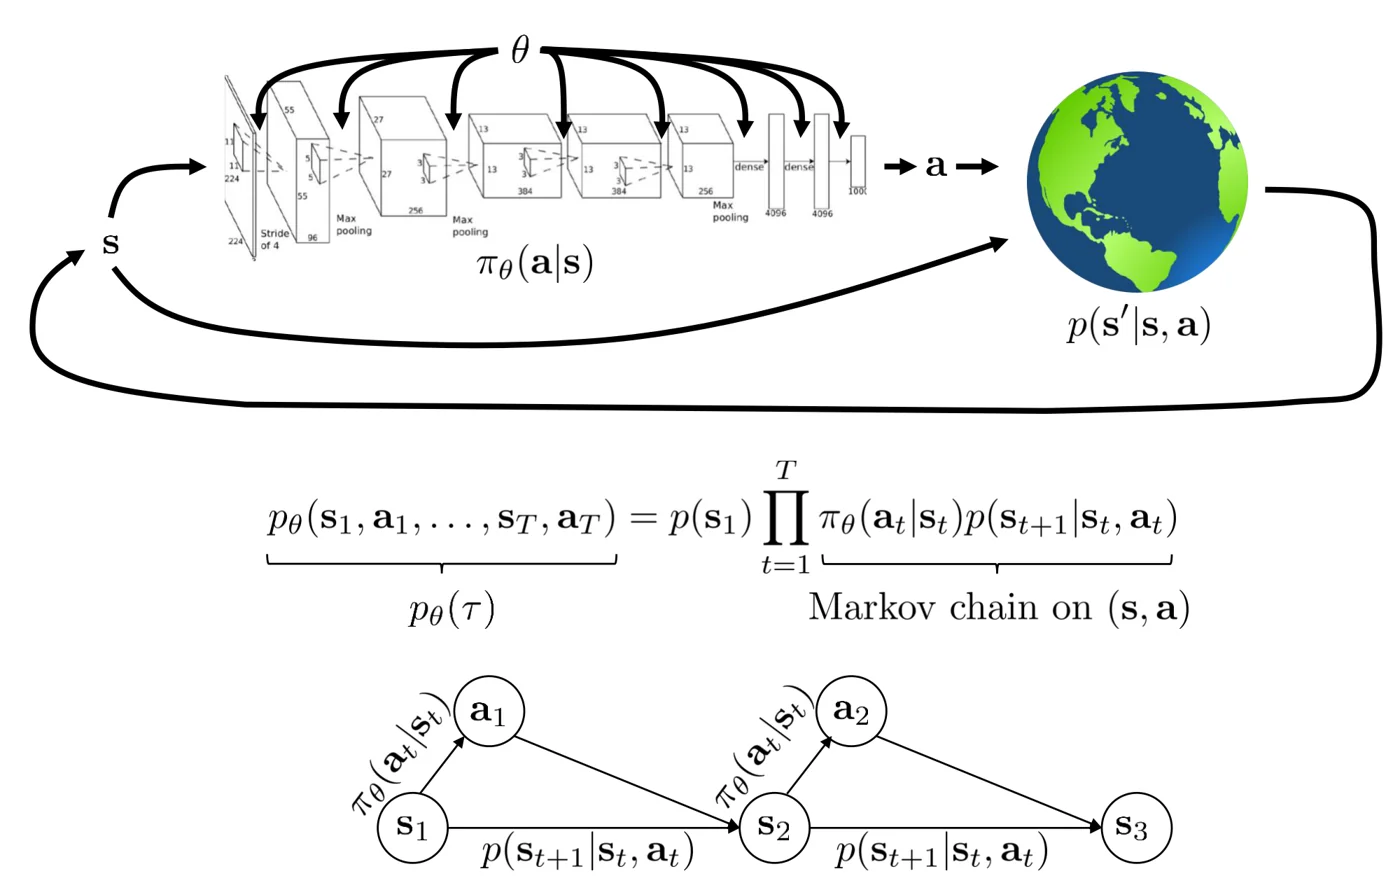 정책 \(\pi_\theta(a \mid s)\)(신경망)와 환경 \(p(s' \mid s, a)\)가 고리를 이루어 궤적을 만든다. 아래의 그래프 모형은 정책 화살표 \(\pi_\theta(a_t \mid s_t)\)가 추가된 \((s, a)\) 위의 마르코프 연쇄다. 출처: CS 182 Lecture 15 slides.
그림 위쪽은 상호작용 고리다. 상태 \(s\)가 파라미터 \(\theta\)를 가진 합성곱 신경망에 들어가 행동 \(a\)의 분포 \(\pi_\theta(a \mid s)\)를 내고, 뽑힌 행동이 환경(지구 그림)에 들어가면 환경은 \(p(s' \mid s, a)\)에 따라 다음 상태를 돌려준다. 그 상태가 다시 정책의 입력이 되며 고리가 이어진다. \(\theta\)에서 나온 화살표가 신경망의 각 층으로만 들어간다는 점에 주목할 만하다. 학습으로 바꿀 수 있는 것은 정책뿐이고 환경은 바꿀 수 없다.
아래쪽 그래프 모형은 앞의 MDP 그림에 \(s_t \to a_t\) 화살표(정책)를 추가한 것이다. 이렇게 하면 \((s_t, a_t)\) 쌍 전체가 하나의 마르코프 연쇄를 이루고, 궤적의 확률은 초기 상태 확률에 정책 확률과 전이 확률을 시각마다 번갈아 곱한 값이 된다. 바로 위의 \(p_\theta(\tau)\) 분해식이 이 그림을 그대로 옮긴 것이다.
\[\theta^\star = \arg\max_\theta \; \mathbb{E}_{\tau \sim p_\theta(\tau)} \left[ \sum_{t} r(s_t, a_t) \right]\]보상 함수가 미분 불가능해도, 동역학을 몰라도 이 목적을 최적화할 수 있어야 한다는 점이 핵심이다. 다음 파트에서 이를 경사 상승으로 푸는 방법을 유도한다.
정책 경사의 유도 (Policy Gradient Derivation)
슬라이드는 이 파트를 “수식의 벽(wall of math)”이라 부른다.
목적 함수의 평가
목적 함수를 \(J(\theta)\)로 쓰고 \(r(\tau) = \sum_t r(s_t, a_t)\)로 두자.
\[J(\theta) = \mathbb{E}_{\tau \sim p_\theta(\tau)} \left[ r(\tau) \right] = \int p_\theta(\tau)\, r(\tau)\, d\tau\]\(J(\theta)\)의 값은 정책을 실제로 실행해 \(N\)개의 궤적을 샘플링하고 평균을 내면 추정할 수 있다.
\[J(\theta) \approx \frac{1}{N} \sum_{i=1}^{N} \sum_{t} r(s_{i,t}, a_{i,t})\]직접 미분하기: 로그 미분 트릭
기울기를 구하려면 \(\nabla_\theta p_\theta(\tau)\)가 필요하다. 여기서 편리한 항등식을 쓴다.
\[p_\theta(\tau)\, \nabla_\theta \log p_\theta(\tau) = p_\theta(\tau) \frac{\nabla_\theta p_\theta(\tau)}{p_\theta(\tau)} = \nabla_\theta p_\theta(\tau)\]이를 대입하면 기울기를 다시 기댓값의 형태로 쓸 수 있다.
\[\nabla_\theta J(\theta) = \int \nabla_\theta p_\theta(\tau)\, r(\tau)\, d\tau = \int p_\theta(\tau)\, \nabla_\theta \log p_\theta(\tau)\, r(\tau)\, d\tau = \mathbb{E}_{\tau \sim p_\theta(\tau)} \left[ \nabla_\theta \log p_\theta(\tau)\, r(\tau) \right]\]궤적 확률의 로그를 펼치기
궤적 분포의 로그는 다음과 같다.
\[\log p_\theta(\tau) = \log p(s_1) + \sum_{t=1}^{T} \left[ \log \pi_\theta(a_t \mid s_t) + \log p(s_{t+1} \mid s_t, a_t) \right]\]초기 상태 분포와 전이 확률은 \(\theta\)에 의존하지 않으므로 기울기를 취하면 사라진다. 따라서 다음을 얻는다.
\[\nabla_\theta J(\theta) = \mathbb{E}_{\tau \sim p_\theta(\tau)} \left[ \left( \sum_{t=1}^{T} \nabla_\theta \log \pi_\theta(a_t \mid s_t) \right) \left( \sum_{t=1}^{T} r(s_t, a_t) \right) \right]\]이 식에는 동역학 \(p(s_{t+1} \mid s_t, a_t)\)가 전혀 등장하지 않는다. 동역학을 몰라도 샘플만으로 기울기를 추정할 수 있다.
정책 경사의 추정: REINFORCE
샘플로 기댓값을 근사하면 다음과 같다.
\[\nabla_\theta J(\theta) \approx \frac{1}{N} \sum_{i=1}^{N} \left( \sum_{t=1}^{T} \nabla_\theta \log \pi_\theta(a_{i,t} \mid s_{i,t}) \right) \left( \sum_{t=1}^{T} r(s_{i,t}, a_{i,t}) \right)\] \[\theta \leftarrow \theta + \alpha \nabla_\theta J(\theta)\]이것이 REINFORCE 알고리즘(Williams, 1992)이다. 강화학습 알고리즘의 일반적인 구조인 세 단계 루프에 맞춰 보면 다음과 같다.
- 샘플 생성: 정책 \(\pi_\theta(a_t \mid s_t)\)를 실행하여 궤적 \(\{\tau^i\}\)를 얻는다.
- 수익 추정: 각 궤적의 보상 합을 계산한다(이 경우 그냥 더하기만 하면 된다).
- 정책 개선: \(\theta \leftarrow \theta + \alpha \nabla_\theta J(\theta)\).
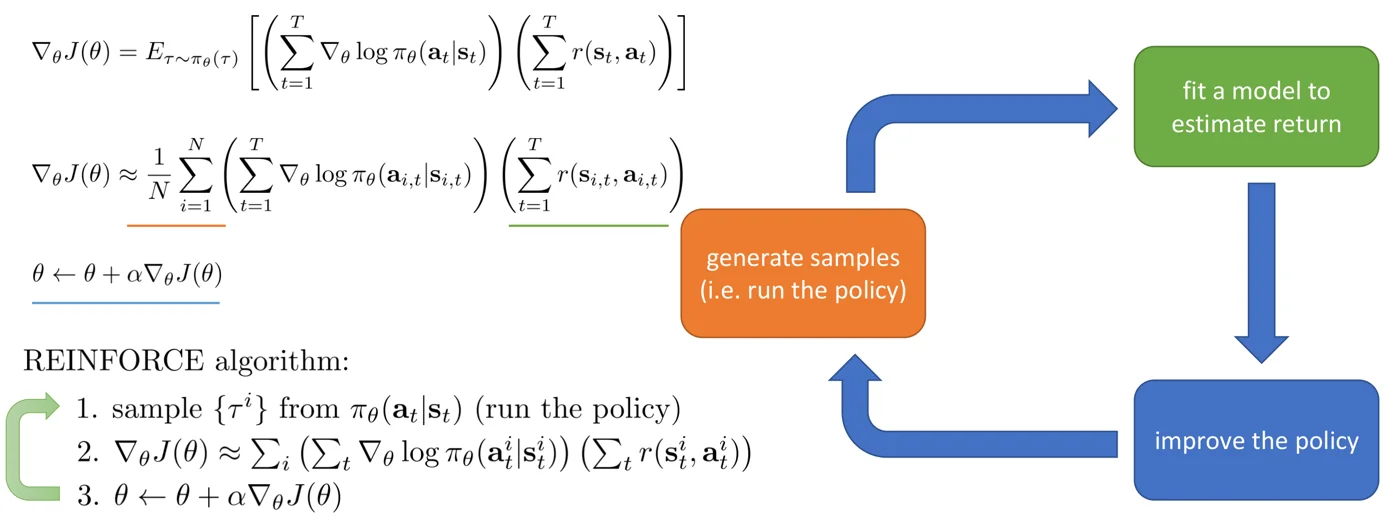 REINFORCE의 각 식이 강화학습의 세 단계 루프 중 어디에 해당하는지를 색 밑줄로 대응시킨 그림. 주황은 샘플 생성, 초록은 수익 추정, 파랑은 정책 개선이다. 출처: CS 182 Lecture 15 slides.
그림의 밑줄 색을 따라 읽으면 구조가 분명해진다. 주황 밑줄의 \(\frac{1}{N}\sum_{i}\)는 정책을 \(N\)번 실행해 얻은 샘플에 대한 평균이므로 주황 상자(샘플 생성)에 해당한다. 초록 밑줄의 \(\sum_t r(s_{i,t}, a_{i,t})\)는 각 궤적의 수익을 구하는 부분으로, 초록 상자(수익 추정 모델 적합)에 해당하지만 REINFORCE에서는 모델을 따로 맞추지 않고 보상을 더하기만 한다. 파랑 밑줄의 경사 상승 갱신이 파랑 상자(정책 개선)다. 왼쪽 아래의 초록 화살표는 1-3단계가 반복된다는 뜻이다. 갱신된 정책으로 다시 샘플을 모아야 하므로 루프 전체를 돌아야 한다.
최대우도와의 비교
행동 복제처럼 최대우도로 정책을 학습할 때의 기울기는 다음과 같다.
\[\nabla_\theta J_{\text{ML}}(\theta) \approx \frac{1}{N} \sum_{i=1}^{N} \left( \sum_{t=1}^{T} \nabla_\theta \log \pi_\theta(a_{i,t} \mid s_{i,t}) \right)\]정책 경사는 이 최대우도 기울기를 각 궤적의 보상 \(r(\tau_i)\)로 가중한 것이다. 보상이 높은 궤적은 로그 확률이 올라가고, 보상이 낮은 궤적은 로그 확률이 내려간다. 즉 좋은 것은 더 일어나게, 나쁜 것은 덜 일어나게 한다. 정책 경사는 “시행착오(trial and error)”라는 개념을 수식으로 정식화한 것이다.
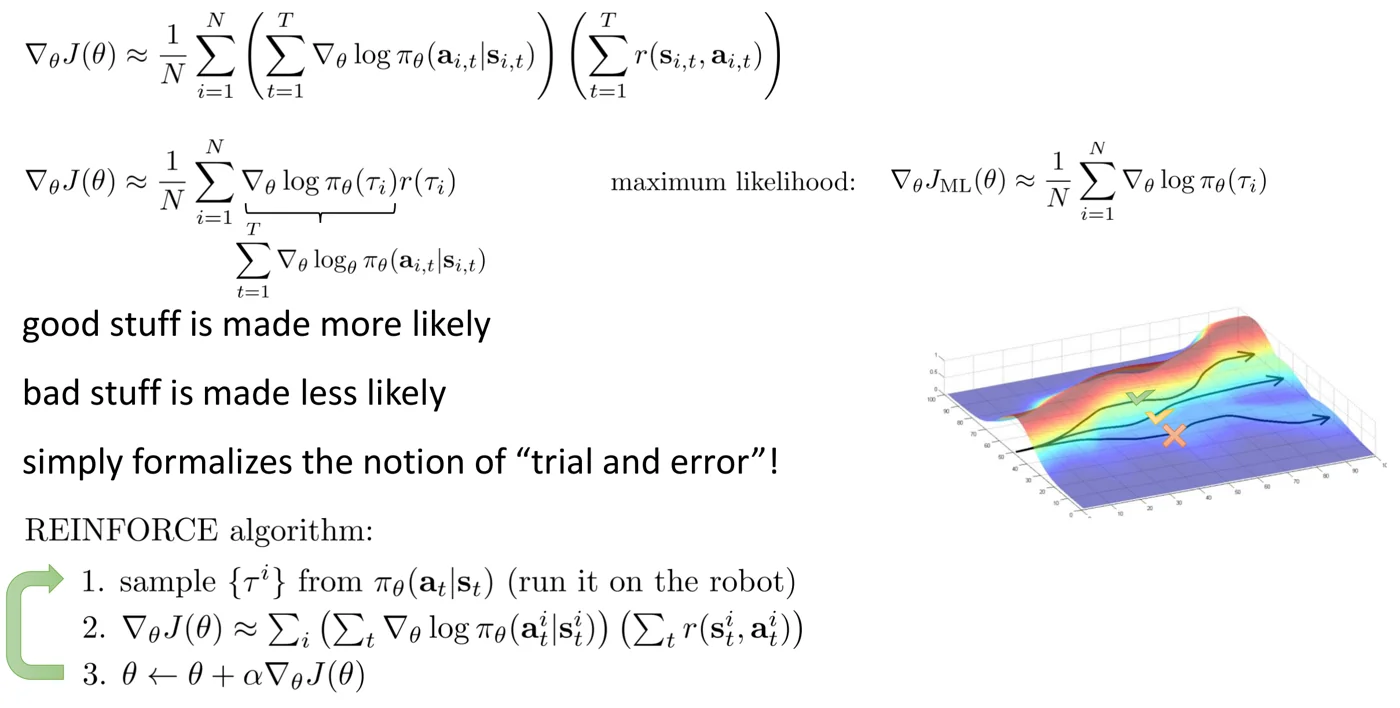 정책 경사와 최대우도 기울기를 나란히 놓은 슬라이드. 오른쪽 곡면은 궤적 공간 위의 확률 분포이고, 체크 표시가 붙은 궤적(좋은 결과)의 확률은 올라가고 X 표시가 붙은 궤적(나쁜 결과)의 확률은 내려간다. 출처: CS 182 Lecture 15 slides.
그림 둘째 줄에서 시각별 로그 확률의 합 \(\sum_t \nabla_\theta \log \pi_\theta(a_{i,t} \mid s_{i,t})\)를 \(\nabla_\theta \log \pi_\theta(\tau_i)\)로 묶어 쓰면 비교가 쉬워진다. 최대우도는 모든 샘플 궤적의 로그 확률을 똑같이 올리지만, 정책 경사는 같은 기울기에 \(r(\tau_i)\)를 곱한다. 오른쪽 곡면 그림에서 높이는 정책이 각 궤적에 부여하는 확률이다. 경사 단계를 한 번 밟을 때마다 보상이 큰 궤적 주변으로 확률 질량이 옮겨 가고, 보상이 작은 궤적 주변의 질량은 줄어든다. 여러 번 시도해 본 뒤 잘된 시도를 더 자주 하게 만드는 것이 곧 시행착오다.
부분 관측
유도 과정에서 마르코프 성질은 쓰이지 않았다. \(\log p_\theta(\tau)\)를 펼쳤을 때 정책 항만 남는다는 사실만 썼다. 따라서 \(s_t\)를 \(o_t\)로 바꿔도 같은 식이 성립한다.
\[\nabla_\theta J(\theta) \approx \frac{1}{N} \sum_{i=1}^{N} \left( \sum_{t=1}^{T} \nabla_\theta \log \pi_\theta(a_{i,t} \mid o_{i,t}) \right) \left( \sum_{t=1}^{T} r(s_{i,t}, a_{i,t}) \right)\]정책 경사는 부분 관측 환경에서도 수정 없이 사용할 수 있다.
정책 경사를 실제로 작동시키기 (Making Policy Gradient Work)
위 추정량은 불편(unbiased)하지만 분산이 매우 크다. 같은 정책에서 다른 샘플을 뽑으면 기울기가 크게 달라진다. 이 파트는 분산을 줄이는 방법과 실용적인 고려사항을 다룬다.
더 나은 추정량: 보상-투-고
인과성(causality): 시각 \(t\)에 고른 행동은 \(t' < t\)인 과거 시각 \(t'\)의 보상에 영향을 줄 수 없다. 따라서 \(\nabla_\theta \log \pi_\theta(a_{i,t} \mid s_{i,t})\)에는 \(t\) 이후의 보상만 곱해도 기댓값이 같다.
\[\nabla_\theta J(\theta) \approx \frac{1}{N} \sum_{i=1}^{N} \sum_{t=1}^{T} \nabla_\theta \log \pi_\theta(a_{i,t} \mid s_{i,t}) \underbrace{\left( \sum_{t'=t}^{T} r(s_{i,t'}, a_{i,t'}) \right)}_{\hat{Q}_{i,t}}\]\(\hat{Q}_{i,t}\)를 보상-투-고(reward-to-go) 라 한다. 더해지는 항이 줄어드므로 분산이 작아진다.
기준선
보상이 모두 양수라면, 모든 궤적의 확률을 올리는 방향으로 기울기가 나온다. 정작 원하는 것은 평균보다 좋은 궤적은 올리고 평균보다 나쁜 궤적은 내리는 것이다. 그래서 기준선(baseline) \(b\)를 뺀다.
\[\nabla_\theta J(\theta) \approx \frac{1}{N} \sum_{i=1}^{N} \nabla_\theta \log p_\theta(\tau_i) \left[ r(\tau_i) - b \right], \qquad b = \frac{1}{N} \sum_{i=1}^{N} r(\tau_i)\]이렇게 해도 되는가? 앞의 항등식 \(p_\theta \nabla_\theta \log p_\theta = \nabla_\theta p_\theta\)를 쓰면 상수 기준선 항의 기댓값은 0이다.
\[\mathbb{E}\left[ \nabla_\theta \log p_\theta(\tau)\, b \right] = \int p_\theta(\tau) \nabla_\theta \log p_\theta(\tau)\, b \, d\tau = b\, \nabla_\theta \int p_\theta(\tau)\, d\tau = b\, \nabla_\theta 1 = 0\]따라서 기준선을 빼도 기댓값에서 불편이다. 평균 보상은 최적의 기준선은 아니지만 꽤 좋은 선택이다.
정책 경사는 온폴리시다
\(\nabla_\theta J(\theta) = \mathbb{E}_{\tau \sim p_\theta(\tau)}[\cdots]\)의 기댓값은 현재 정책의 궤적 분포에 대한 것이다. 정책이 바뀔 때마다 새 샘플을 모아야 하고, 이전 정책의 샘플은 버려야 한다. 이를 온폴리시(on-policy) 라 한다. 신경망은 한 번의 경사 단계에서 조금씩만 바뀌므로, 매 단계마다 샘플을 새로 모으는 것은 매우 비효율적일 수 있다.
오프폴리시 학습과 중요도 샘플링
다른 분포 \(\bar{p}(\tau)\)의 샘플로 \(p_\theta(\tau)\)에 대한 기댓값을 구하려면 중요도 샘플링(importance sampling) 을 쓴다.
\[\mathbb{E}_{x \sim p(x)}[f(x)] = \int p(x) f(x)\, dx = \int q(x) \frac{p(x)}{q(x)} f(x)\, dx = \mathbb{E}_{x \sim q(x)} \left[ \frac{p(x)}{q(x)} f(x) \right]\]궤적에 적용하면 초기 상태 분포와 전이 확률이 분자와 분모에서 약분되어 정책 항만 남는다.
\[\frac{p_\theta(\tau)}{\bar{p}(\tau)} = \frac{p(s_1) \prod_t \pi_\theta(a_t \mid s_t) p(s_{t+1} \mid s_t, a_t)}{p(s_1) \prod_t \bar\pi(a_t \mid s_t) p(s_{t+1} \mid s_t, a_t)} = \frac{\prod_t \pi_\theta(a_t \mid s_t)}{\prod_t \bar\pi(a_t \mid s_t)}\]중요도 샘플링으로 정책 경사 유도하기
이전 정책 \(\pi_\theta\)의 샘플로 새 파라미터 \(\theta'\)의 목적 함수를 쓰면 다음과 같다.
\[J(\theta') = \mathbb{E}_{\tau \sim p_\theta(\tau)} \left[ \frac{p_{\theta'}(\tau)}{p_\theta(\tau)} r(\tau) \right]\]\(\theta'\)에 대해 미분하고 같은 항등식 \(\nabla_{\theta'} p_{\theta'}(\tau) = p_{\theta'}(\tau) \nabla_{\theta'} \log p_{\theta'}(\tau)\)를 쓰면 다음과 같다.
\[\nabla_{\theta'} J(\theta') = \mathbb{E}_{\tau \sim p_\theta(\tau)} \left[ \frac{p_{\theta'}(\tau)}{p_\theta(\tau)} \nabla_{\theta'} \log p_{\theta'}(\tau)\, r(\tau) \right]\]\(\theta' = \theta\)로 두면 비율이 1이 되어 원래의 온폴리시 정책 경사로 돌아간다.
오프폴리시 정책 경사
\(\theta' \neq \theta\)인 경우 정책 항을 펼치고 인과성을 적용하면 다음과 같다.
\[\nabla_{\theta'} J(\theta') = \mathbb{E}_{\tau \sim p_\theta(\tau)} \left[ \sum_{t=1}^{T} \nabla_{\theta'} \log \pi_{\theta'}(a_t \mid s_t) \left( \prod_{t'=1}^{t} \frac{\pi_{\theta'}(a_{t'} \mid s_{t'})}{\pi_\theta(a_{t'} \mid s_{t'})} \right) \left( \sum_{t'=t}^{T} r(s_{t'}, a_{t'}) \left( \prod_{t''=t}^{t'} \frac{\pi_{\theta'}(a_{t''} \mid s_{t''})}{\pi_\theta(a_{t''} \mid s_{t''})} \right) \right) \right]\]미래 보상에 붙는 마지막 비율 곱을 무시하면 정책 반복(policy iteration) 알고리즘이 되며, 이는 다음 강의에서 다룬다. 문제는 첫 번째 비율 곱이 \(T\)에 대해 지수적으로 커지거나 작아진다는 것이다. 1보다 작은 수를 여러 번 곱하면 0으로, 1보다 큰 수를 여러 번 곱하면 무한대로 간다.
중요도 샘플링의 1차 근사
목적 함수를 시점별 상태-행동 주변분포로 다시 쓰면 다음과 같다.
\[\nabla_{\theta'} J(\theta') \approx \frac{1}{N} \sum_{i=1}^{N} \sum_{t=1}^{T} \frac{\pi_{\theta'}(s_{i,t})}{\pi_\theta(s_{i,t})} \frac{\pi_{\theta'}(a_{i,t} \mid s_{i,t})}{\pi_\theta(a_{i,t} \mid s_{i,t})} \nabla_{\theta'} \log \pi_{\theta'}(a_{i,t} \mid s_{i,t})\, \hat{Q}_{i,t}\]상태 주변분포의 비율 \(\pi_{\theta'}(s_{i,t}) / \pi_\theta(s_{i,t})\)는 계산할 수 없으므로 무시한다. 그러면 행동 확률의 비율 하나만 남아 지수적 폭발이 사라진다. 이 근사는 \(\theta'\)가 \(\theta\)와 가까울 때 합리적이며, 실제로 매우 흔히 쓰인다. 슬라이드의 추천 문헌에 있는 PPO 같은 방법이 이런 형태를 사용한다.
자동 미분으로 구현하기
\(\nabla_\theta \log \pi_\theta(a_t \mid s_t)\)를 샘플마다 따로 계산하는 것은 비효율적이다. 대신 기울기가 정책 경사가 되는 대리 목적 함수(surrogate objective) 를 만들고 자동 미분에 맡긴다.
\[\tilde{J}(\theta) \approx \frac{1}{N} \sum_{i=1}^{N} \sum_{t=1}^{T} \log \pi_\theta(a_{i,t} \mid s_{i,t})\, \hat{Q}_{i,t}\]\(\hat{Q}_{i,t}\)는 상수로 취급한다. 이산 행동이면 구현은 최대우도와 거의 같다. 최대우도에서는 softmax 교차 엔트로피(음의 로그우도)의 평균을 손실로 쓴다. 정책 경사에서는 각 샘플의 음의 로그우도에 \(\hat{Q}_{i,t}\)(q_values)를 곱한 뒤 평균을 낸다. 즉 “가중 최대우도”를 역전파하면 된다.
실전 팁
- 기울기의 분산이 크다는 것을 기억해야 한다. 지도학습과 다르며, 기울기에 잡음이 매우 많다.
- 훨씬 큰 배치를 고려한다.
- 학습률 조정이 매우 어렵다. Adam 같은 적응적 스텝 크기 방법은 그럭저럭 쓸 만하다. 정책 경사 전용 학습률 조정 방법은 나중에 배운다.
정책 경사는 어디에 쓰이는가
- 제어 학습.
- “하드” 어텐션(hard attention): 네트워크가 이미지의 어디를 볼지 이산적으로 선택한다(Mnih et al., Recurrent Models of Visual Attention).
- 이산 잠재 변수 모델(뒤에서 다룬다).
요약하면, 정책 경사(REINFORCE)는 확률적이지만 미분 불가능한 연산을 통과해 미분해야 하는 모든 상황에 쓸 수 있다.
예: TRPO
Trust region policy optimization(Schulman et al. 2015)은 자연 경사(natural gradient)와 자동 스텝 크기 조정을 결합한 정책 경사 방법이며, 이산 행동과 연속 행동 모두에 쓸 수 있다. 추천 문헌으로는 REINFORCE를 제안한 Williams(1992), 최적 기준선과 자연 경사를 다룬 Peters & Schaal(2008), TRPO와 PPO(Schulman et al. 2017) 등이 소개된다.
정리
- MDP는 \(\{\mathcal{S}, \mathcal{A}, \mathcal{T}, r\}\)로 정의되고, 정책과 동역학이 궤적 분포 \(p_\theta(\tau) = p(s_1)\prod_t \pi_\theta(a_t \mid s_t) p(s_{t+1} \mid s_t, a_t)\)를 정한다. 목표는 기대 총보상의 최대화다.
- 로그 미분 트릭 \(\nabla_\theta p_\theta = p_\theta \nabla_\theta \log p_\theta\)로 기울기를 기댓값으로 바꾸면, 동역학 항이 사라지고 샘플만으로 정책 경사를 추정할 수 있다(REINFORCE).
- 정책 경사는 보상으로 가중한 최대우도 기울기이며, 시행착오를 정식화한 것이다. 마르코프 성질을 쓰지 않으므로 부분 관측에서도 그대로 성립한다.
- 분산을 줄이기 위해 인과성을 이용한 보상-투-고와 기준선을 쓴다. 상수 기준선은 기댓값을 바꾸지 않는다.
- 정책 경사는 온폴리시다. 중요도 샘플링으로 오프폴리시 버전을 유도할 수 있지만 비율 곱이 \(T\)에 지수적이므로, 상태 비율을 무시하는 1차 근사가 실전에서 흔히 쓰인다.
- 구현은 \(\hat{Q}\)로 가중한 음의 로그우도를 자동 미분하는 것이다. 기울기 잡음이 크므로 큰 배치와 신중한 학습률 조정이 필요하다.