- UC Berkeley CS 182 (Spring 2021) 16강 정리
- 강의: Sergey Levine
- 관련 Discussion: Discussion 9
액터-크리틱 (Actor-Critic)
정책 경사 다시 보기
앞 강의의 보상-투-고 정책 경사는 다음과 같았다.
\[\nabla_\theta J(\theta) \approx \frac{1}{N} \sum_{i=1}^{N} \sum_{t=1}^{T} \nabla_\theta \log \pi_\theta(a_{i,t} \mid s_{i,t})\, \hat{Q}_{i,t}, \qquad \hat{Q}_{i,t} = \sum_{t'=t}^{T} r(s_{i,t'}, a_{i,t'})\]\(\hat{Q}_{i,t}\)는 상태 \(s_{i,t}\)에서 행동 \(a_{i,t}\)를 했을 때 받을 미래 보상의 추정치다. 그런데 이것은 샘플 하나로 만든 추정치다. 같은 상태에서 같은 행동을 해도 정책과 환경의 확률성 때문에 궤적이 매번 달라지므로, 이 추정치는 불편이지만 분산이 크다. 만약 진짜 기대 보상-투-고를 알 수 있다면 분산이 훨씬 작아질 것이다.
상태 가치 함수와 상태-행동 가치 함수
진짜 기대 보상-투-고를 Q-함수(state-action value function) 라 한다.
\[Q^\pi(s_t, a_t) = \sum_{t'=t}^{T} \mathbb{E}_{\pi_\theta} \left[ r(s_{t'}, a_{t'}) \mid s_t, a_t \right]\]상태만 조건으로 하는 가치 함수(value function) 는 행동에 대해 평균을 낸 것이다.
\[V^\pi(s_t) = \mathbb{E}_{a_t \sim \pi_\theta(a_t \mid s_t)} \left[ Q^\pi(s_t, a_t) \right]\]기준선은 어떻게 하나
앞 강의에서 기준선으로 평균 보상을 썼다. 상태마다 다른 기준선을 쓸 수 있다면 더 좋다. 자연스러운 선택은 \(V^\pi(s_t)\)다. 이 상태에서 평균적으로 얻는 값이므로, 이를 빼면 “이 행동이 평균보다 얼마나 좋은가”가 남는다. 이를 어드밴티지(advantage) 라 한다.
\[A^\pi(s_t, a_t) = Q^\pi(s_t, a_t) - V^\pi(s_t)\] \[\nabla_\theta J(\theta) \approx \frac{1}{N} \sum_{i=1}^{N} \sum_{t=1}^{T} \nabla_\theta \log \pi_\theta(a_{i,t} \mid s_{i,t})\, A^\pi(s_{i,t}, a_{i,t})\]어드밴티지 추정이 정확할수록 분산이 낮아진다.
가치 함수 적합
\(Q^\pi\), \(V^\pi\), \(A^\pi\) 중 무엇을 학습해야 할까? Q-함수는 다음과 같이 다시 쓸 수 있다.
\[Q^\pi(s_t, a_t) = r(s_t, a_t) + \mathbb{E}_{s_{t+1} \sim p(s_{t+1} \mid s_t, a_t)} \left[ V^\pi(s_{t+1}) \right] \approx r(s_t, a_t) + V^\pi(s_{t+1})\]마지막 근사는 다음 상태의 기댓값을 실제로 관측한 하나의 \(s_{t+1}\)로 바꾼 것이다. 그러면 어드밴티지도 \(V\)만으로 근사할 수 있다.
\[A^\pi(s_t, a_t) \approx r(s_t, a_t) + V^\pi(s_{t+1}) - V^\pi(s_t)\]\(V^\pi\)는 상태만 입력으로 받으므로 행동까지 받는 Q-함수보다 학습하기 쉽다. 그래서 신경망 \(\hat{V}^\pi_\phi(s)\)를 학습한다. 이를 정책 평가(policy evaluation) 라 한다. 정책을 바꾸지 않고 그 정책이 얼마나 좋은지를 평가하는 것이다. 강화학습 목적 함수 자체도 \(J(\theta) = \mathbb{E}_{s_1 \sim p(s_1)}[V^\pi(s_1)]\)로 쓸 수 있다.
몬테카를로 평가와 함수 근사
가장 단순한 방법은 몬테카를로(Monte Carlo) 추정이다. 각 상태에서 실제로 받은 보상-투-고를 목표값으로 삼는다.
\[V^\pi(s_t) \approx \sum_{t'=t}^{T} r(s_{t'}, a_{t'})\]이상적으로는 같은 상태에서 여러 번 재시작해 평균을 내야 하지만 보통은 불가능하다. 신경망으로 근사하면 이 문제가 완화된다. 비슷한 상태들이 비슷한 값을 갖도록 일반화되므로, 같은 함수가 여러 샘플을 동시에 맞추게 되기 때문이다. 훈련 데이터는 \(\{(s_{i,t}, y_{i,t})\}\), \(y_{i,t} = \sum_{t'=t}^{T} r(s_{i,t'}, a_{i,t'})\)이고 지도 회귀로 학습한다.
\[\mathcal{L}(\phi) = \frac{1}{2} \sum_{i} \left\lVert \hat{V}^\pi_\phi(s_i) - y_i \right\rVert^2\]더 잘할 수 있을까: 부트스트랩
이상적인 목표값은 진짜 기댓값이다.
\[y_{i,t} = r(s_{i,t}, a_{i,t}) + \sum_{t'=t+1}^{T} \mathbb{E}_{\pi_\theta}\left[ r(s_{t'}, a_{t'}) \mid s_{i,t+1} \right] \approx r(s_{i,t}, a_{i,t}) + V^\pi(s_{i,t+1}) \approx r(s_{i,t}, a_{i,t}) + \hat{V}^\pi_\phi(s_{i,t+1})\]뒤쪽 합을 현재의 추정치 \(\hat{V}^\pi_\phi\)로 대신하는 것을 부트스트랩(bootstrap) 추정이라 한다. 추정치가 틀릴 수 있으므로 편향이 생기지만, 샘플 하나의 긴 보상 합보다 분산이 훨씬 작다. 훈련 데이터는 \(\{(s_{i,t},\ r(s_{i,t}, a_{i,t}) + \hat{V}^\pi_\phi(s_{i,t+1}))\}\)이다.
슬라이드는 정책 평가의 성공 사례로 TD-Gammon(Tesauro, 1992)과 AlphaGo(Silver et al., 2016)를 든다. 둘 다 게임 상태의 가치를 신경망으로 평가한다.
액터-크리틱 알고리즘
정책(액터, actor)과 가치 함수(크리틱, critic)를 함께 학습하는 배치 액터-크리틱(batch actor-critic) 알고리즘은 다음과 같다.
- 정책 \(\pi_\theta(a \mid s)\)를 실행하여 샘플 \(\{s_i, a_i\}\)를 얻는다.
- 샘플된 보상으로 \(\hat{V}^\pi_\phi(s)\)를 적합한다.
- \(\hat{A}^\pi(s_i, a_i) = r(s_i, a_i) + \hat{V}^\pi_\phi(s'_i) - \hat{V}^\pi_\phi(s_i)\)를 계산한다.
- \(\nabla_\theta J(\theta) \approx \sum_i \nabla_\theta \log \pi_\theta(a_i \mid s_i)\, \hat{A}^\pi(s_i, a_i)\).
- \(\theta \leftarrow \theta + \alpha \nabla_\theta J(\theta)\).
여담: 할인율
에피소드 길이 \(T\)가 무한대이면 \(\hat{V}\)가 무한히 커질 수 있다. 끝이 있는 과제(episodic task)뿐 아니라 계속되거나 순환하는 과제(continuous/cyclical task)도 있기 때문이다. 해결책은 나중의 보상보다 지금의 보상을 더 선호하도록 할인율(discount factor) \(\gamma \in [0, 1]\)을 쓰는 것이다. \(\gamma = 0.99\) 정도가 흔하다.
\[y_{i,t} \approx r(s_{i,t}, a_{i,t}) + \gamma \hat{V}^\pi_\phi(s_{i,t+1})\]해석하면 매 단계 \(1 - \gamma\)의 확률로 에피소드가 끝나는(죽는) MDP와 같다. 할인율을 넣은 정책 경사의 보상-투-고는 \(\sum_{t'=t}^{T} \gamma^{t'-t} r(s_{i,t'}, a_{i,t'})\)가 된다.
할인율을 쓴 액터-크리틱
배치 액터-크리틱은 위 알고리즘의 2, 3단계에서 \(\hat{A}^\pi(s_i, a_i) = r(s_i, a_i) + \gamma \hat{V}^\pi_\phi(s'_i) - \hat{V}^\pi_\phi(s_i)\)를 쓴다.
온라인 액터-크리틱(online actor-critic) 은 전이 하나마다 갱신한다.
- 행동 \(a \sim \pi_\theta(a \mid s)\)를 하고 \((s, a, s', r)\)을 얻는다.
- 목표값 \(r + \gamma \hat{V}^\pi_\phi(s')\)로 \(\hat{V}^\pi_\phi\)를 갱신한다.
- \(\hat{A}^\pi(s, a) = r(s, a) + \gamma \hat{V}^\pi_\phi(s') - \hat{V}^\pi_\phi(s)\)를 계산한다.
- \(\nabla_\theta J(\theta) \approx \nabla_\theta \log \pi_\theta(a \mid s)\, \hat{A}^\pi(s, a)\).
- \(\theta \leftarrow \theta + \alpha \nabla_\theta J(\theta)\).
구조 설계
- 두 네트워크 설계: 상태 \(s\)를 받아 \(\hat{V}^\pi_\phi(s)\)를 내는 네트워크와 \(\pi_\theta(a \mid s)\)를 내는 네트워크를 따로 둔다. 단순하고 안정적이지만 액터와 크리틱이 특징(feature)을 공유하지 못한다.
- 공유 네트워크 설계: 하나의 몸통에서 두 개의 출력 헤드로 가치와 정책을 낸다. 특징을 공유할 수 있지만 두 손실의 균형을 맞추기가 더 까다롭다.
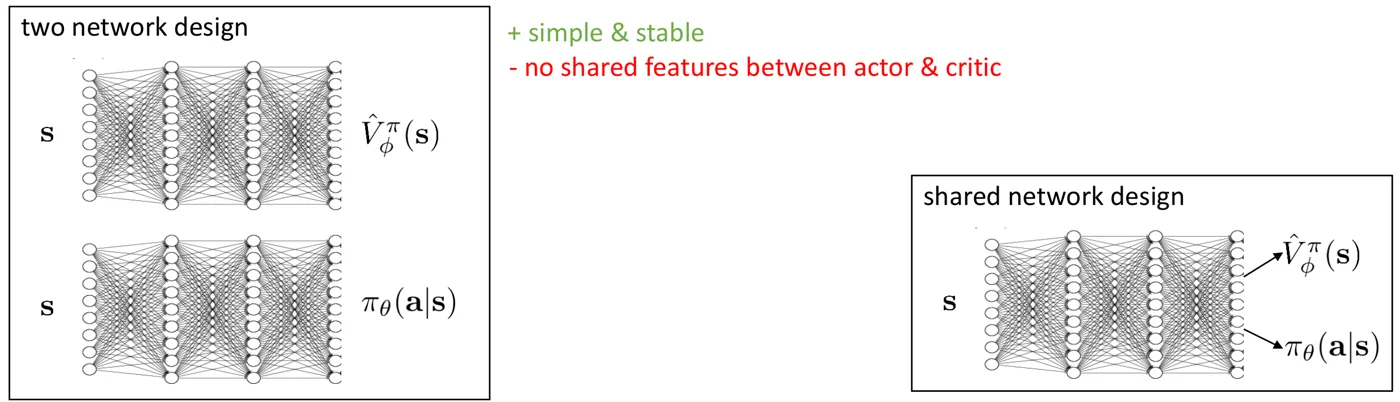 액터-크리틱의 두 가지 구조. 왼쪽은 같은 상태 \(s\)를 받는 두 개의 독립된 네트워크가 각각 \(\hat{V}^\pi_\phi(s)\)와 \(\pi_\theta(a \mid s)\)를 내고, 오른쪽은 하나의 몸통 끝에서 두 출력으로 갈라진다. 출처: CS 182 Lecture 16 slides.
왼쪽 설계에서는 크리틱의 파라미터 \(\phi\)와 액터의 파라미터 \(\theta\)가 완전히 분리되어 있다. 크리틱은 회귀 손실 \(\frac{1}{2}\lVert \hat{V}^\pi_\phi(s_i) - y_i \rVert^2\)만, 액터는 정책 경사만 받으므로 서로 간섭하지 않고 구현과 튜닝이 쉽다. 대신 상태 \(s\)에서 유용한 특징(예: 이미지 속 물체의 위치)을 두 네트워크가 각자 따로 배워야 한다.
오른쪽 설계에서는 은닉층을 공유하고 마지막 층에서만 두 헤드로 나뉜다. 공유 몸통은 두 손실의 기울기를 모두 받으므로 특징을 한 번만 배우면 되지만, 회귀 손실과 정책 경사의 크기가 서로 다르기 때문에 가중치를 잘못 잡으면 한쪽 기울기가 다른 쪽을 압도할 수 있다. 이미지처럼 입력이 고차원이라 특징 학습 비용이 클수록 공유 설계의 이점이 커진다.
가치 기반 방법: 정책 반복과 Fitted Q-Iteration (Value-Based Methods)
가치 함수만으로 충분할까
\(A^\pi(s_t, a_t)\)는 정책 \(\pi\)를 따를 때 \(a_t\)가 평균적인 행동보다 얼마나 좋은지를 나타낸다. 그렇다면 \(\arg\max_{a_t} A^\pi(s_t, a_t)\)는 \(s_t\) 이후 \(\pi\)를 따른다는 가정 아래 최선의 행동이다. 이 행동은 \(\pi\)가 무엇이든 적어도 \(\pi\)의 행동만큼 좋다.
그러면 정책 경사를 완전히 버리고 다음과 같은 결정적 정책을 쓰면 된다.
\[\pi'(a_t \mid s_t) = \begin{cases} 1 & \text{if } a_t = \arg\max_{a_t} A^\pi(s_t, a_t) \\ 0 & \text{otherwise} \end{cases}\]정책 반복
고수준 아이디어인 정책 반복(policy iteration) 은 다음을 반복한다.
- \(A^\pi(s, a)\)를 평가한다.
- \(\pi \leftarrow \pi'\)로 둔다.
문제는 1단계, 즉 \(A^\pi\)를 어떻게 평가하느냐다. \(A^\pi(s, a) = r(s, a) + \gamma \mathbb{E}[V^\pi(s')] - V^\pi(s)\)이므로 \(V^\pi\)를 평가하면 된다.
동적 계획법
상태와 행동이 적고 이산적이며 전이 확률 \(p(s' \mid s, a)\)를 안다고 하자. 예를 들어 4×4 격자 세계에서 상태 16개, 행동 4개라면 \(V^\pi(s)\)를 표(table)로 저장할 수 있다. 부트스트랩 갱신은 다음과 같다.
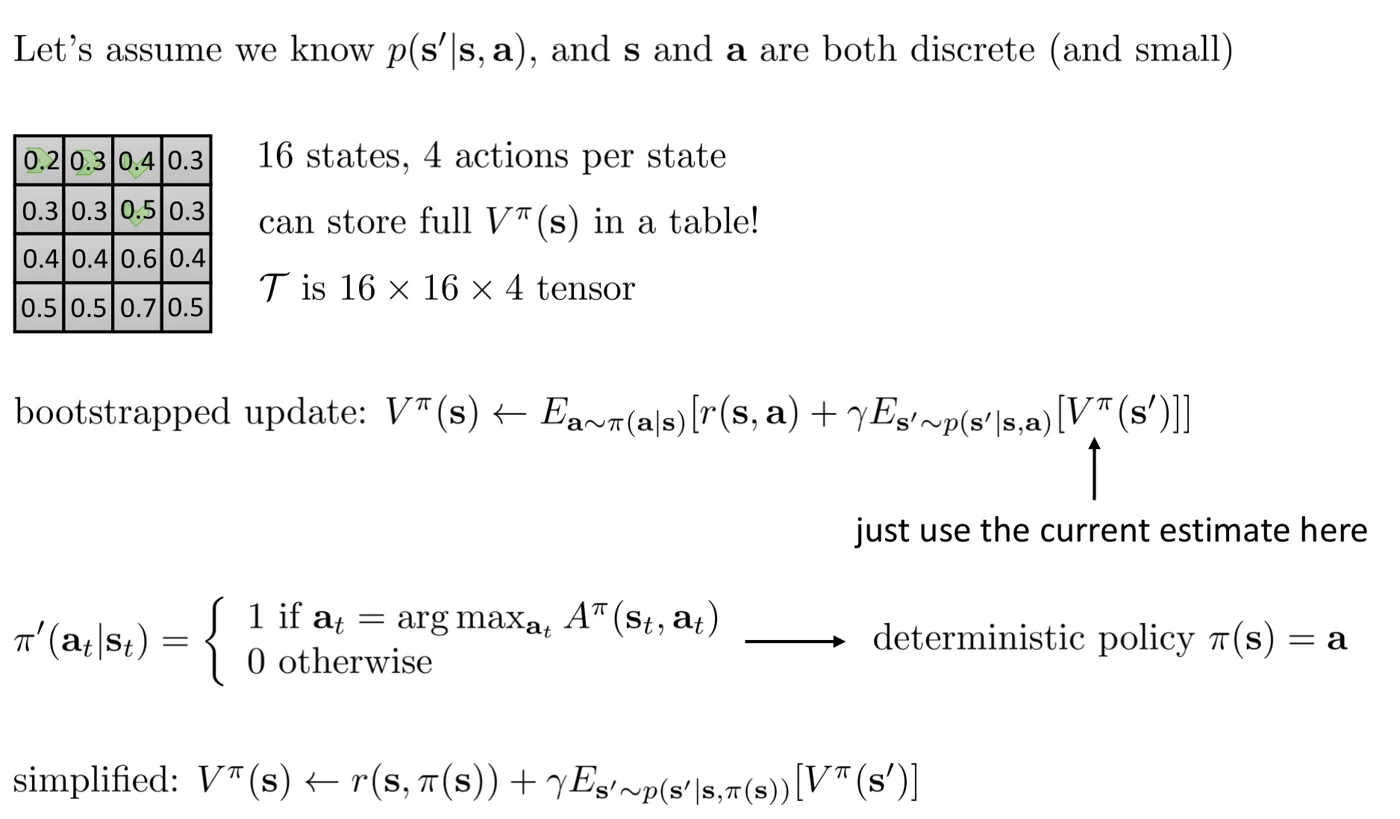 4×4 격자 세계의 표 형식 가치 함수. 각 칸의 숫자가 그 상태의 \(V^\pi(s)\)이고, 전이 연산자 \(\mathcal{T}\)는 \(16 \times 16 \times 4\) 텐서로 저장된다. 아래는 부트스트랩 갱신식과 결정적 정책을 쓸 때의 단순화된 형태다. 출처: CS 182 Lecture 16 slides.
그림의 표는 신경망 없이 상태마다 숫자 하나를 저장하는 가장 단순한 가치 함수다. 상태가 16개, 행동이 4개이므로 전이 확률 \(p(s' \mid s, a)\)는 “현재 상태 16 × 다음 상태 16 × 행동 4”개의 숫자로 모두 적을 수 있다. 부트스트랩 갱신은 각 칸의 값을 “즉시 보상 + 할인된 이웃 칸 값의 기댓값”으로 덮어쓰는 연산이며, 화살표가 가리키듯 오른쪽의 \(V^\pi(s')\)에는 아직 정확하지 않은 현재 표의 값을 그대로 넣는다. 이 갱신을 모든 칸에 대해 반복하면 표의 값이 실제 \(V^\pi\)로 수렴한다.
\[V^\pi(s) \leftarrow \mathbb{E}_{a \sim \pi(a \mid s)} \left[ r(s, a) + \gamma \mathbb{E}_{s' \sim p(s' \mid s, a)} [V^\pi(s')] \right]\]오른쪽의 \(V^\pi(s')\)에는 현재 추정치를 그냥 사용한다. \(\pi\)가 결정적이면 \(V^\pi(s) \leftarrow r(s, \pi(s)) + \gamma \mathbb{E}_{s'}[V^\pi(s')]\)로 간단해진다.
정책 반복에 동적 계획법을 쓰면 1단계에서 이 갱신을 수렴할 때까지 반복해 \(V^\pi\)를 구하고, 2단계에서 \(\arg\max\) 정책으로 바꾼다.
더 간단한 동적 계획법: 가치 반복
\(\arg\max_a A^\pi(s, a) = \arg\max_a Q^\pi(s, a)\)이다. \(V^\pi(s)\)는 \(a\)에 의존하지 않기 때문이다. 그런데 새 정책이 \(\arg\max\) 행동을 고르므로 그 정책의 가치는 \(\max_a Q(s, a)\)로 바로 근사할 수 있다. 정책을 명시적으로 만들 필요가 없다. 가치 반복(value iteration) 은 다음을 반복한다.
- \(Q(s, a) \leftarrow r(s, a) + \gamma \mathbb{E}[V(s')]\)로 둔다.
- \(V(s) \leftarrow \max_a Q(s, a)\)로 둔다.
Fitted Value Iteration
상태 공간이 크면(예: 이미지) 표로 저장할 수 없다. 이미지 하나의 가능한 값 조합은 천문학적으로 많다. 이것이 차원의 저주(curse of dimensionality) 다. 그래서 신경망 \(V_\phi(s)\)로 근사한다. fitted value iteration 은 다음을 반복한다.
- \(y_i \leftarrow \max_{a_i} \left( r(s_i, a_i) + \gamma \mathbb{E}[V_\phi(s'_i)] \right)\)로 둔다.
- \(\phi \leftarrow \arg\min_\phi \frac{1}{2} \sum_i \lVert V_\phi(s_i) - y_i \rVert^2\).
전이 동역학을 모르면?
1단계의 \(\max_{a_i}\)를 계산하려면 같은 상태 \(s_i\)에서 여러 행동을 했을 때의 결과를 알아야 한다. 동역학을 모르면 같은 상태로 돌아가 다른 행동을 해 볼 수 없으므로 불가능하다.
정책 반복으로 돌아가 보자. \(V^\pi\) 대신 Q-함수를 평가할 수 있다.
\[Q^\pi(s, a) \leftarrow r(s, a) + \gamma \mathbb{E}_{s' \sim p(s' \mid s, a)} \left[ Q^\pi(s', \pi(s')) \right]\]이 갱신은 샘플로 적합할 수 있다. \((s, a, s')\) 하나만 있으면 오른쪽을 계산할 수 있기 때문이다. 정책 \(\pi\)가 바뀌어도 \(\pi(s')\)만 다시 계산하면 되고, \((s, a)\)는 어떤 정책으로 모은 것이어도 상관없다.
다시 “max” 트릭
같은 아이디어를 Q-값에 적용하여, 전이 확률을 모르면서도 정책 없이 가치를 직접 계산할 수 있다. \(\mathbb{E}[V(s'_i)] \approx \max_{a'} Q_\phi(s'_i, a')\)로 근사하면 된다. fitted Q-iteration 은 다음을 반복한다.
- \(y_i \leftarrow r(s_i, a_i) + \gamma \max_{a'_i} Q_\phi(s'_i, a'_i)\)로 둔다.
- \(\phi \leftarrow \arg\min_\phi \frac{1}{2} \sum_i \lVert Q_\phi(s_i, a_i) - y_i \rVert^2\).
장단점은 다음과 같다.
- 행동을 시뮬레이션할 필요가 없다. \(\max\)는 네트워크 출력에 대해 계산하면 된다.
- 오프폴리시 샘플로도 작동한다(액터-크리틱과 다르다).
- 네트워크가 하나뿐이고, 분산이 큰 정책 경사가 없다.
- 단점: 비선형 함수 근사에서는 수렴 보장이 없다.
전체 알고리즘은 다음과 같다. 어떤 정책으로든 데이터셋 \(\{(s_i, a_i, s'_i, r_i)\}\)를 모으고, 목표값을 계산하고 회귀하는 두 단계를 \(K\)번 반복한 뒤, 다시 데이터를 모으는 과정을 되풀이한다.
심층 Q-Learning (Deep Q-Learning)
온라인 Q-learning
fitted Q-iteration을 전이 하나씩 처리하도록 바꾸면 온라인 Q-learning 이 된다.
- 행동 \(a_i\)를 하고 \((s_i, a_i, s'_i, r_i)\)를 관측한다.
- \(y_i = r(s_i, a_i) + \gamma \max_{a'} Q_\phi(s'_i, a')\).
- \(\phi \leftarrow \phi - \alpha \frac{dQ_\phi}{d\phi}(s_i, a_i) \left( Q_\phi(s_i, a_i) - y_i \right)\).
오프폴리시 알고리즘이므로 1단계에서 어떤 정책을 써도 된다. 선택지가 많다.
Q-learning의 탐험
학습이 끝난 뒤 최종 정책은 탐욕 정책 \(\pi(a_t \mid s_t) = 1\) if \(a_t = \arg\max_{a_t} Q_\phi(s_t, a_t)\)이다. 그런데 1단계에서 이 정책을 그대로 쓰면 안 된다. 현재 추정이 틀렸을 때 다른 행동을 해 볼 기회가 없기 때문이다. 대표적인 탐험(exploration) 방법은 두 가지다.
엡실론-탐욕(epsilon-greedy): 확률 \(1 - \epsilon\)으로 \(\arg\max\) 행동을, 나머지 확률로 다른 행동을 균등하게 고른다.
\[\pi(a_t \mid s_t) = \begin{cases} 1 - \epsilon & \text{if } a_t = \arg\max_{a_t} Q_\phi(s_t, a_t) \\ \epsilon / (\lvert \mathcal{A} \rvert - 1) & \text{otherwise} \end{cases}\]볼츠만 탐험(Boltzmann exploration): Q-값에 비례하는 softmax 분포로 행동을 고른다. 좋아 보이는 행동일수록 자주 고르지만 다른 행동도 시도한다.
\[\pi(a_t \mid s_t) \propto \exp\left( Q_\phi(s_t, a_t) \right)\]무엇이 문제인가
온라인 Q-learning의 3단계는 경사 하강처럼 보이지만 경사 하강이 아니다. 목표값 \(y_i\)도 \(\phi\)에 의존하는데, 그 경로로는 기울기를 흘리지 않기 때문이다. 어떤 고정된 목적 함수의 기울기도 아니므로 수렴이 보장되지 않는다.
또 두 가지 문제가 있다.
- 연속된 상태는 강하게 상관되어 있다. 지도학습의 i.i.d. 가정이 깨지므로, 네트워크가 최근에 본 상태들에 과적합했다가 다른 곳으로 가면 그것을 잊는다.
- 목표값이 계속 바뀐다.
리플레이 버퍼
fitted Q-iteration은 데이터를 모으는 정책과 무관하게 작동한다. 넓게 퍼진 분포라면 어떤 정책도 괜찮다. 온라인 Q-learning은 \(K = 1\)이고 경사 단계가 한 번인 특수한 경우일 뿐이다. 그러니 방금 본 전이 대신 전이들의 데이터셋에서 샘플을 불러오면 된다. 이를 리플레이 버퍼(replay buffer) \(\mathcal{B}\)라 한다.
- \(\mathcal{B}\)에서 배치 \((s_i, a_i, s'_i, r_i)\)를 샘플링한다.
- \(\phi \leftarrow \phi - \alpha \sum_i \frac{dQ_\phi}{d\phi}(s_i, a_i) \left( Q_\phi(s_i, a_i) - \left[ r(s_i, a_i) + \gamma \max_{a'_i} Q_\phi(s'_i, a'_i) \right] \right)\).
이점은 다음과 같다.
- 샘플들이 더 이상 상관되어 있지 않다.
- 배치에 여러 샘플이 들어가므로 기울기의 분산이 낮다.
데이터는 어디서 오는가? 주기적으로 버퍼를 채워야 한다. 엡실론-탐욕 같은 탐험 정책으로 전이를 모아 \(\mathcal{B}\)에 추가하고, 버퍼에서 \(K\)번 배치를 샘플링해 갱신하는 과정을 반복한다. \(K = 1\)이 흔하지만 \(K\)가 크면 더 효율적이다.
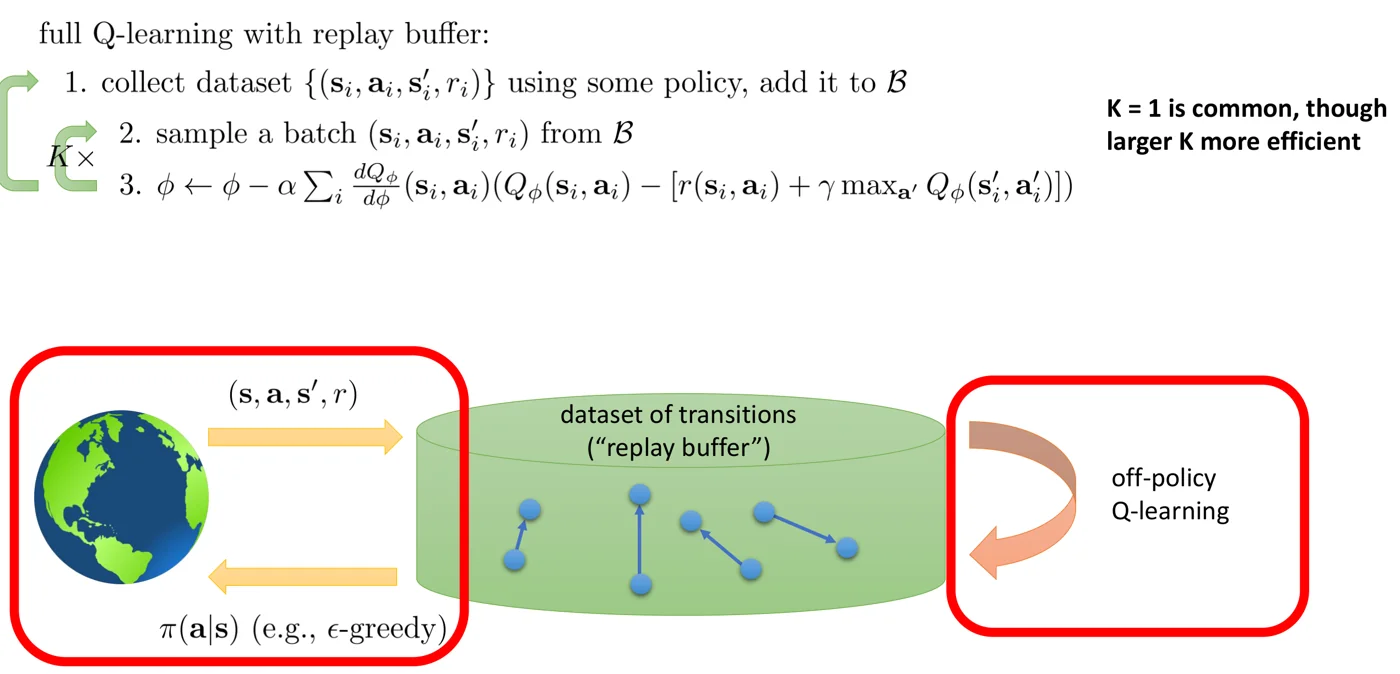 리플레이 버퍼를 쓰는 전체 Q-learning. 왼쪽 빨간 상자는 환경과 상호작용하며 \((s, a, s', r)\) 전이를 버퍼에 넣는 부분, 오른쪽 빨간 상자는 버퍼에서 배치를 꺼내 오프폴리시 Q-learning 갱신을 하는 부분이다. 출처: CS 182 Lecture 16 slides.
그림의 두 빨간 상자는 서로 독립적으로 돌아가는 두 과정이다. 왼쪽 과정은 현재 Q-함수로 만든 엡실론-탐욕 정책 \(\pi(a \mid s)\)로 환경에서 행동하고, 관측한 전이를 초록색 원통(버퍼)에 쌓는다. 버퍼 안의 화살표 하나가 전이 하나 \((s \to s')\)를 뜻하며, 서로 다른 시점과 정책에서 모인 전이가 뒤섞여 있다. 오른쪽 과정은 이 버퍼에서 무작위로 배치를 뽑아 위 알고리즘의 2-3단계를 \(K\)번 수행한다. 무작위로 뽑으므로 배치 안의 샘플은 연속된 궤적의 일부가 아니며, 상관 문제가 크게 줄어든다. Q-learning이 오프폴리시이기 때문에 오래된 정책이 모은 전이도 그대로 쓸 수 있다는 점이 이 구조를 가능하게 한다.
Q-learning과 회귀
리플레이 버퍼를 써도 “경사 하강이 아니다”라는 문제는 남는다. 목표값이 매 단계 바뀌는 움직이는 목표(moving target) 에 대해 한 번씩만 경사 단계를 밟기 때문이다. 반면 fitted Q-iteration의 2단계 \(\phi \leftarrow \arg\min_\phi \frac{1}{2}\sum_i \lVert Q_\phi(s_i, a_i) - y_i \rVert^2\)는 목표값이 고정되어 있으므로 완벽하게 정의된 안정적인 회귀 문제다.
타깃 네트워크
그래서 목표값을 계산하는 파라미터를 따로 두고 천천히 갱신한다. 타깃 네트워크(target network) \(\phi'\)를 쓰는 Q-learning은 다음과 같다.
- \(\phi' \leftarrow \phi\)로 저장한다.
- 어떤 정책으로 데이터 \(\{(s_i, a_i, s'_i, r_i)\}\)를 모아 \(\mathcal{B}\)에 추가한다.
- \(\mathcal{B}\)에서 배치를 샘플링한다.
- \(\phi \leftarrow \phi - \alpha \sum_i \frac{dQ_\phi}{d\phi}(s_i, a_i) \left( Q_\phi(s_i, a_i) - \left[ r(s_i, a_i) + \gamma \max_{a'} Q_{\phi'}(s'_i, a') \right] \right)\).
3-4단계를 \(K\)번, 2-4단계를 \(N\)번 반복한 뒤 1단계로 돌아간다. 안쪽 루프에서는 목표값이 바뀌지 않으므로 지도 회귀와 같다.
고전적 심층 Q-learning (DQN)
Mnih et al.(2013)의 DQN 은 위에서 \(K = 1\)인 경우다.
- 행동 \(a_i\)를 하고 \((s_i, a_i, s'_i, r_i)\)를 관측하여 \(\mathcal{B}\)에 추가한다.
- \(\mathcal{B}\)에서 미니배치 \((s_j, a_j, s'_j, r_j)\)를 균등하게 샘플링한다.
- 타깃 네트워크로 \(y_j = r_j + \gamma \max_{a'_j} Q_{\phi'}(s'_j, a'_j)\)를 계산한다.
- \(\phi \leftarrow \phi - \alpha \sum_j \frac{dQ_\phi}{d\phi}(s_j, a_j) \left( Q_\phi(s_j, a_j) - y_j \right)\).
- \(N\) 단계마다 \(\phi' \leftarrow \phi\)로 복사한다.
Q-함수의 표현
- 이산 행동에서 흔한 방식: 네트워크가 상태 \(s\)를 받아 모든 행동에 대한 Q-값을 한꺼번에 출력한다. 출력 차원이 \(\lvert \mathcal{A} \rvert\)이고 \(\max_a\)는 출력 중 최댓값이다.
- 연속 행동에서 흔한 방식: 네트워크가 \((s, a)\)를 함께 입력으로 받아 스칼라 \(Q(s, a)\)를 출력한다.
다시 액터-크리틱으로
연속 행동에서는 목표값의 \(\max_{a'} Q_\phi(s', a')\)를 계산하기가 매우 불편하다(불가능하지는 않다). 대안은 Q-함수를 쓰는 액터-크리틱으로 오프폴리시 학습을 하는 것이다. 정책 \(\pi_\theta\)가 \(\max\)를 대신한다.
\[y_i = r(s_i, a_i) + \gamma Q_{\phi'}(s'_i, a'_i), \qquad a'_i \sim \pi_\theta(a' \mid s'_i)\]정책은 정책 경사로 \(\mathbb{E}_{a \sim \pi_\theta(a \mid s)}[Q_\phi(s, a)]\)를 최대화하도록 학습한다. 크리틱이 Q-함수이므로 리플레이 버퍼의 오프폴리시 데이터로 학습할 수 있다.
Q-learning 실전 팁
- Q-learning은 안정화하는 데 신경을 써야 한다.
- 먼저 쉽고 신뢰할 수 있는 과제에서 시험해 구현이 맞는지 확인한다.
- 큰 리플레이 버퍼가 안정성을 높인다. 그러면 fitted Q-iteration에 더 가까워진다.
- 시간이 걸린다. 한동안은 무작위 정책보다 나을 게 없을 수 있으니 인내심을 가져야 한다.
- 탐험(\(\epsilon\))을 크게 시작해서 점차 줄인다.
사례
- Atari DQN (Mnih et al.): 합성곱 신경망으로 Q-learning을 하여 픽셀 입력으로 Atari 게임을 학습했다. 리플레이 버퍼와 타깃 네트워크, 1단계 백업, 한 번의 경사 단계를 쓴다. 이중 Q-learning(double Q-learning) 등 여러 트릭으로 크게 개선할 수 있다.
- QT-Opt (Kalashnikov et al.): 연속 행동 Q-learning을 대규모로 확장해 로봇 집기를 학습했다. 실시간 데이터 수집과 과거 모든 실험의 저장 데이터를 훈련 버퍼에 모으고, 벨만 갱신기(Bellman updater)와 훈련 스레드를 분산 실행한다.
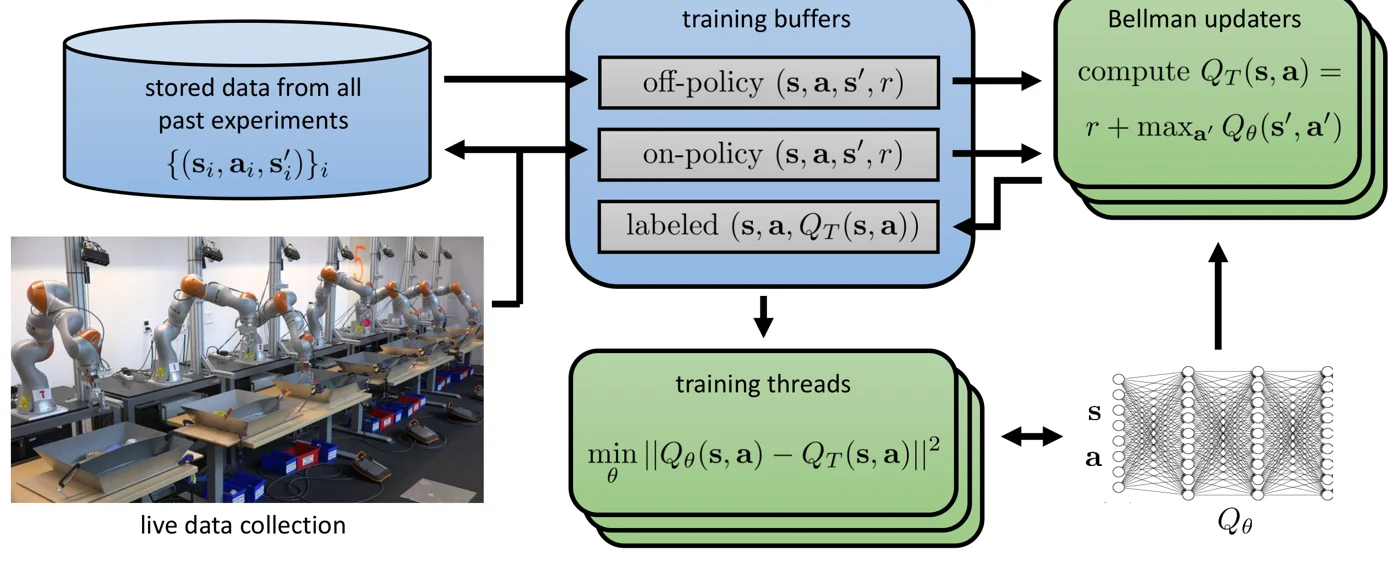 QT-Opt의 시스템 구성. 과거 실험의 저장 데이터와 여러 대의 로봇이 실시간으로 모은 데이터가 훈련 버퍼로 들어가고, 벨만 갱신기가 목표값 \(Q_T(s, a)\)를 붙이면 훈련 스레드가 \(\lVert Q_\theta(s, a) - Q_T(s, a) \rVert^2\)를 최소화한다. 출처: CS 182 Lecture 16 slides.
그림은 이 강의의 fitted Q-iteration과 리플레이 버퍼를 대규모 분산 시스템으로 옮긴 형태다. 파란 훈련 버퍼에는 오프폴리시 전이, 온폴리시 전이, 목표값이 붙은 전이의 세 칸이 있다. 오른쪽 위의 벨만 갱신기(여러 장이 겹친 상자는 여러 프로세스가 병렬로 돈다는 뜻이다)는 전이를 꺼내 \(r + \max_{a'} Q_\theta(s', a')\)를 계산해 “labeled” 칸에 되돌려 놓는다. 아래의 훈련 스레드는 이렇게 라벨이 붙은 데이터로 회귀를 수행하여 \(Q_\theta\)를 갱신하고, 갱신된 \(Q_\theta\)는 다시 벨만 갱신기와 로봇의 행동 선택에 쓰인다. 목표값 계산과 회귀를 분리했다는 점에서 타깃 네트워크와 같은 안정화 효과를 얻는다. 행동이 연속이므로 \(\max_{a'}\)는 행동 공간에서 샘플링 기반 최적화로 근사한다.
정리
- Q-함수 \(Q^\pi(s, a)\)는 기대 보상-투-고, 가치 함수 \(V^\pi(s)\)는 그 행동 평균이다. 어드밴티지 \(A^\pi = Q^\pi - V^\pi\)를 쓰면 정책 경사의 분산이 줄어든다.
- 액터-크리틱은 크리틱 \(\hat{V}_\phi\)를 부트스트랩 목표값 \(r + \gamma \hat{V}_\phi(s')\)로 회귀 학습하고, \(\hat{A} = r + \gamma \hat{V}_\phi(s') - \hat{V}_\phi(s)\)로 액터를 갱신한다. 무한 시평에서는 할인율 \(\gamma\)를 쓴다.
- \(\arg\max_a A^\pi(s, a)\) 정책은 \(\pi\)보다 나쁘지 않다. 이것이 정책 반복이며, 정책 없이 \(V(s) \leftarrow \max_a Q(s, a)\)로 쓰면 가치 반복이다.
- 동역학을 모를 때는 Q-함수를 쓴다. fitted Q-iteration은 \(y = r + \gamma \max_{a'} Q_\phi(s', a')\)로 회귀하며 오프폴리시 데이터로 학습할 수 있지만, 비선형 근사에서 수렴 보장은 없다.
- 온라인 Q-learning은 경사 하강이 아니며 샘플 상관과 움직이는 목표 문제가 있다. 리플레이 버퍼가 상관을, 타깃 네트워크가 움직이는 목표를 해결한다. 둘을 합친 것이 DQN이다.
- 탐험에는 엡실론-탐욕이나 볼츠만 탐험을 쓴다. 연속 행동에서는 \(\max\) 대신 정책을 쓰는 Q-함수 기반 액터-크리틱이 대안이다.